一层 = 一次矩阵乘
上一课:一个神经元把 3 个数变成 1 个数。
这一课:把 3 个这样的神经元并排放在一起。
三个神经元并排
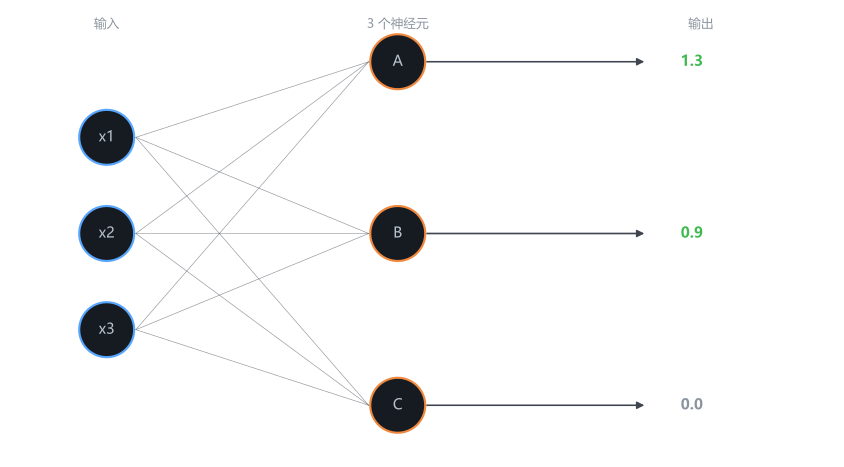
同一个输入 x 同时喂给三个神经元,每个有自己的一套权重和偏置。
每个算一次,得到三个数。这三个数就是这一层的输出。
输入 | 输出 | |
|---|---|---|
一个神经元 | 3 个数 | 1 个数 |
三个神经元 | 3 个数 | 3 个数 |
逐数字算一遍
三个神经元并排,听起来是三次独立的计算。先老老实实算一遍,再看它怎么变成一次矩阵乘。
输入 x = [2, 3, 1] 神经元 A: w = [0.5, -0.2, 0.8] b = 0.1 神经元 B: w = [0.1, 0.4, -0.3] b = -0.2 神经元 C: w = [-0.6, 0.2, 0.5] b = 0.0神经元 A
2×0.5 + 3×(-0.2) + 1×0.8 = 1.0 - 0.6 + 0.8 = 1.2 1.2 + 0.1 = 1.3 ReLU(1.3) = 1.3神经元 B
2×0.1 + 3×0.4 + 1×(-0.3) = 0.2 + 1.2 - 0.3 = 1.1 1.1 + (-0.2) = 0.9 ReLU(0.9) = 0.9神经元 C
2×(-0.6) + 3×0.2 + 1×0.5 = -1.2 + 0.6 + 0.5 = -0.1 -0.1 + 0.0 = -0.1 ReLU(-0.1) = 0.0 ← 被截断这一层的输出是 [1.3, 0.9, 0.0]。
3 个数进,3 个数出。
不用矩阵会写成什么样
上面三行代码就是“不用矩阵”的样子。三个神经元还能忍,一百个就不能了。
a = relu(x[0]*wA[0] + x[1]*wA[1] + x[2]*wA[2] + bA) b = relu(x[0]*wB[0] + x[1]*wB[1] + x[2]*wB[2] + bB) c = relu(x[0]*wC[0] + x[1]*wC[1] + x[2]*wC[2] + bC)三个神经元写三行。如果一层有 128 个神经元呢?写 128 行。
而且每一行长得一模一样,只有权重不同——这就是矩阵该出场的地方。
把三个神经元的权重摞起来
三行代码的共同点是什么?都是“输入点乘一组权重”。把这三组权重叠起来放。
把三套权重按行摆成一个矩阵:
┌ ┐ │ 0.5 -0.2 0.8 │ ← A 的权重 W = │ 0.1 0.4 -0.3 │ ← B 的权重 │ -0.6 0.2 0.5 │ ← C 的权重 └ ┘ 形状 (3, 3):3 个神经元 × 3 个输入偏置也是一个向量:
b = [0.1, -0.2, 0.0] 形状 (3,)然后整个一层就是一行:
输出 = ReLU( x @ Wᵀ + b )3 个数进,3 个数出,一次算完。
把矩阵乘拆开看
写成一行了,但为什么它就等于三个神经元各算一次?
为什么 x @ Wᵀ 就等于三个神经元各算一次?
因为矩阵乘的定义就是"每行做一次点积":
x @ Wᵀ 的第 0 个元素 = x · W 的第 0 行 = 1.2 x @ Wᵀ 的第 1 个元素 = x · W 的第 1 行 = 1.1 x @ Wᵀ 的第 2 个元素 = x · W 的第 2 行 = -0.1矩阵的每一行,就是一个神经元。
这就是「全连接」的含义
矩阵 W 的形状是 (输出维度, 输入维度),每个格子都填了数, 没有一个是 0 或空的。
意味着:每一个输入都连到每一个输出。
后面的卷积层会故意让大部分格子为 0——那是另一种连接方式,第 24 章讲。
代码验证
import torch x = torch.tensor([2.0, 3.0, 1.0]) W = torch.tensor([[ 0.5, -0.2, 0.8], [ 0.1, 0.4, -0.3], [-0.6, 0.2, 0.5]]) b = torch.tensor([0.1, -0.2, 0.0]) out = torch.relu(x @ W.T + b) print(out) # tensor([1.3000, 0.9000, 0.0000])和手算的 [1.3, 0.9, 0.0] 完全一致。
为什么是 W.T 不是 W
PyTorch 的 nn.Linear 存的权重形状是 (输出维度, 输入维度),也就是 (3, 3) 这里。
但矩阵乘要求 (1,3) @ (3,3) 才对得上, 所以要把 W 转置成 (输入, 输出)。
这就是为什么写 x @ W.T。写反了会报形状错误。
批量:一次算 64 个样本
到这里算的都是一个样本。真实训练一次喂一批,形状多出来一维——但规则没变。
真实训练一次喂 64 个样本。输入从 (3,) 变成 (64, 3):
X = torch.randn(64, 3) # 64 个样本,每个 3 个特征 print((X @ W.T + b).shape) # torch.Size([64, 3])形状 | 含义 |
|---|---|
| 64 个样本,每个 3 个特征 |
| 3 个神经元,每个接收 3 个输入 |
| 每个神经元一个偏置,广播到 64 行 |
输出 | 64 个样本,每个 3 个数 |
注意 W 和 b 的形状没变。 不管一次算 1 个样本还是 10000 个,权重矩阵都是一样的——这就是"共享参数"。
用 nn.Linear 就一行
import torch.nn as nn layer = nn.Linear(3, 3) # 3 个输入,3 个输出 print(layer.weight.shape) # torch.Size([3, 3]) print(layer.bias.shape) # torch.Size([3]) out = layer(X) # (64, 3) → (64, 3)nn.Linear(3, 3) 内部做的,就是上面那个矩阵乘加偏置。 没有别的。
nn.Linear(784, 128) 就是:784 个输入,128 个神经元, 权重矩阵 784×128 个数字,也就是 100352 个参数。
参数量怎么算
知道了一层在算什么,最后一个问题:它占多少参数。
层 | 权重 | 偏置 | 合计 |
|---|---|---|---|
| 9 | 3 | 12 |
| 100352 | 128 | 100480 |
| 1280 | 10 | 1290 |
layer = nn.Linear(784, 128) print(sum(p.numel() for p in layer.parameters())) # 100480为什么偏置这么少
权重是"每个输入 × 每个输出",所以是 输入数 × 输出数。
偏置是"每个输出一个",所以只是 输出数。
层越大,权重占比越高——100480 里 100352 是权重。
下一课
一层会了。下一课把三层叠起来,看形状怎么一步步从 784 变成 10。