训练循环的六个零件
前面几课分别造了零件。这一课把它们装起来,跑通 MNIST。
先说清楚我们在认什么
这一章一直在说要「认出数字」,但还没给你看过一个。下面是 MNIST 里的真实样本:
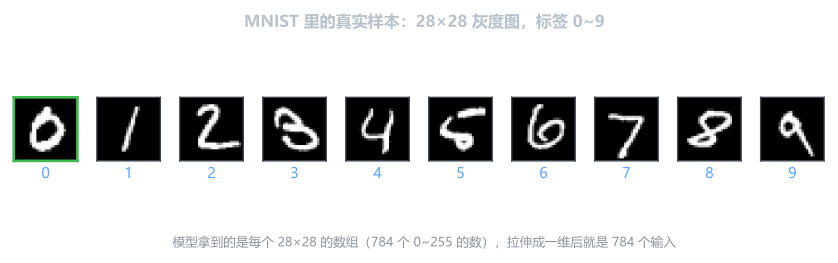
每一张是 28×28 = 784 个 0~255 的数:0 是全黑,255 是全白,中间是灰。 把它按行摊平,就是一个长 784 的向量——这就是网络的输入。
为什么用灰度不用彩色
手写数字的颜色没有信息量——只有笔画深浅有用。灰度图一个通道,彩色三个,省 2/3 的输入。
这也是几乎所有数字识别任务的默认起点。
完整代码
import torch, torch.nn as nn from torch.utils.data import DataLoader from torchvision import datasets, transforms # ── 1. 设备 ──────────────────────────────────────────────── # 有显卡就用显卡。这一行决定后面每个张量要去哪。 # 写死 "cuda" 的话,在没显卡的机器上会直接报错。 device = "cuda" if torch.cuda.is_available() else "cpu" # ── 2. 数据 ──────────────────────────────────────────────── # ToTensor: 把 PIL 图片变成张量,形状 HWC → CHW,像素 0-255 → 0-1 # Normalize: 减均值除标准差。这两个数是 MNIST 训练集统计出来的,不是随便填的 tf = transforms.Compose([ transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,)), # 单通道,所以只有一个数 ]) # download=True 第一次会下载到 ./data,之后直接读缓存 train_ds = datasets.MNIST("./data", train=True, download=True, transform=tf) test_ds = datasets.MNIST("./data", train=False, transform=tf) # 训练集 shuffle=True:不打乱的话模型会先学"全是 0"再学"全是 1",梯度剧烈震荡 # 测试集 shuffle=False:打乱不影响指标,但会让结果对不上号 train_loader = DataLoader(train_ds, batch_size=64, shuffle=True) test_loader = DataLoader(test_ds, batch_size=256, shuffle=False) # ── 3. 模型 ──────────────────────────────────────────────── # 形状流:(64,1,28,28) →Flatten→ (64,784) →Linear→ (64,256) # →ReLU→ (64,256) →Linear→ (64,10) # Dropout 只在训练时生效,评估时自动关闭(靠 model.train()/eval() 切换) model = nn.Sequential( nn.Flatten(), # 28×28 图像拉平成 784 维向量 nn.Linear(784, 256), nn.ReLU(), nn.Dropout(0.2), nn.Linear(256, 10), # 输出 10 个分数,不是概率 ).to(device) # 参数搬到设备上,这一步不能忘 # ── 4. 损失与优化器 ───────────────────────────────────────── # CrossEntropyLoss 内部做了 softmax + log,所以模型最后一层【不要】加 softmax loss_fn = nn.CrossEntropyLoss() # 必须先 .to(device) 再建优化器:优化器持有的是参数对象的引用 # AdamW 而不是 Adam —— 它的 weight_decay 实现才是对的 opt = torch.optim.AdamW(model.parameters(), lr=1e-3) # ── 5. 训练 ──────────────────────────────────────────────── for epoch in range(5): # 训练模式:Dropout 打开,BatchNorm 用当前 batch 的统计量 # 忘了这一句,加了 Dropout 等于没加 model.train() for x, y in train_loader: # 模型在 GPU、数据在 CPU 会报 "Expected all tensors to be on the same device" x, y = x.to(device), y.to(device) pred = model(x) # 前向:(64,10) loss = loss_fn(pred, y) # 一个标量,batch 内平均 # 这三行的顺序是固定的,写反了不会报错但训练会失效 opt.zero_grad() # ① 清空上一轮累积的梯度 loss.backward() # ② 反向传播,算出每个参数的梯度 opt.step() # ③ 按梯度更新参数 # ── 6. 评估 ──────────────────────────────────────────── # 评估模式:Dropout 关闭,BatchNorm 用训练期累计的滑动平均 model.eval() correct = total = 0 # no_grad:不建计算图。不加的话显存会一直涨,最后 OOM with torch.no_grad(): for x, y in test_loader: x, y = x.to(device), y.to(device) pred = model(x).argmax(1) # (64,10) → 每行最大值的下标 (64,) correct += (pred == y).sum().item() # .item() 转成 Python 数字,否则张量越加越慢 total += y.size(0) # 用实际样本数,最后一批可能不满 print(f"epoch {epoch+1} loss {loss.item():.4f} acc {correct/total:.4f}")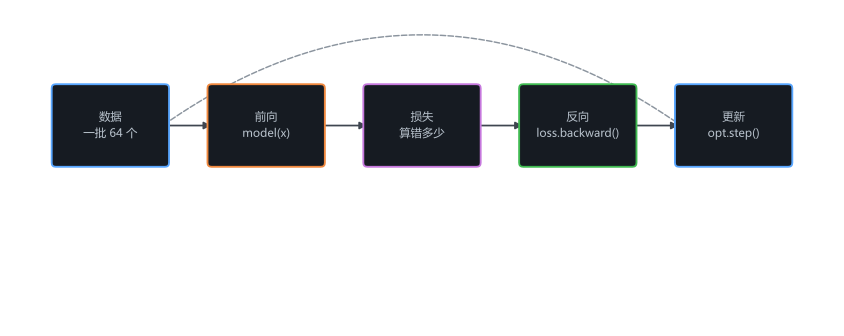
拆开看这六个零件
# | 零件 | 作用 |
|---|---|---|
1 |
| 切换 Dropout / BatchNorm 的行为 |
2 |
| 数据搬到和模型同一设备 |
3 |
| 清掉上一轮的梯度 |
4 |
| 算这一轮的梯度 |
5 |
| 按梯度改参数 |
6 |
| 评估时不建图 |
epoch 和 batch
代码里出现了 epoch 和 batch 两个词,它们不是一回事。
词 | 含义 |
|---|---|
batch(批) | 一次前向 + 反向的样本数 |
iteration(步) | 处理完一个 batch,参数更新一次 |
epoch(轮) | 把整个训练集过一遍 |
60000 样本,batch_size=64 → 每轮 938 步,参数更新 938 次 → 训练 5 轮 = 4690 步训练循环的骨架值得背下来
去掉所有细节之后,这个循环只有十行。后面所有模型都用它。
去掉所有细节,形状是这样:
for epoch in range(E): model.train() for x, y in train_loader: pred = model(x) loss = loss_fn(pred, y) opt.zero_grad() loss.backward() opt.step() model.eval() with torch.no_grad(): for x, y in test_loader: ...后面所有模型(CNN、RNN、Transformer)都用这个骨架, 只有 model 和 loss_fn 换掉。
这就是第 17 课说的「垂直切片」
一旦这个骨架能跑,后面每章只需要换一个零件。
我建议把它抄进一个文件里,之后每章复制粘贴。
第一次跑要检查的事
代码写完了,直接开跑通常不会顺利。先做三个检查。
1. 损失初值对不对
# 10 分类,未训练时应接近 ln(10) = 2.30 print(loss.item())2. 过拟合一个小批量
# 拿一个 batch 反复训练 100 次,损失应该降到接近 0 x, y = next(iter(train_loader)) for i in range(100): loss = loss_fn(model(x), y) opt.zero_grad(); loss.backward(); opt.step() print(loss.item()) # 应该 < 0.01这是最有用的调试手段
如果连一个 batch 都过拟合不了,说明代码有 bug,不是数据问题。
常见原因:损失函数用错、忘了 zero_grad、标签没对齐、模型输出维度不对。
能过拟合一个 batch,才说明整条链路是通的。
3. 准确率起点
10 分类随机猜是 10%。第一轮结束应该有 90% 以上,否则学习率或数据有问题。
几个实用的小改动
能跑通之后,加这几处会好用很多。
累计平均损失
running = 0.0 for i, (x, y) in enumerate(train_loader): ... running += loss.item() if i % 100 == 99: print(f"step {i+1} loss {running/100:.4f}") running = 0.0不要每个 batch 都 print —— 输出会淹没你,而且拖慢训练。
记录到列表里画曲线
history = {"train_loss": [], "val_acc": []} for epoch in range(E): ... history["train_loss"].append(avg_loss) history["val_acc"].append(acc) # 之后用 matplotlib 画常见错误
现象 | 原因 |
|---|---|
损失一直是 2.30 不动 | 学习率太小,或忘了 |
准确率一直是 10% | 标签和输出没对齐 |
报 device 错误 | 数据没 |
第二轮开始变差 | 学习率太大 |
显存越用越多 | 评估忘了 |
结果每次不一样 | 没设随机种子(见下一课) |
下一课
跑通了,还要能复现和保存。下一课讲这两件事。