正则化:weight decay、dropout、早停
模型太强会把训练集背下来。正则化就是故意给它添麻烦,逼它学规律而不是记答案。
先能看出过拟合
训练损失 | 验证损失 | 判断 |
|---|---|---|
高 | 高 | 欠拟合,模型太弱 |
低 | 低 | 刚好 |
很低 | 开始上升 | 过拟合 |
关键信号:训练损失还在降,验证损失已经拐头向上。
weight decay(L2 正则)
看出过拟合了,第一个该加的是它——最省事,几乎总是有用。
在损失里加一项,惩罚大的权重:
L = 原损失 + λ · Σw²opt = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01)λ | 效果 |
|---|---|
0 | 不约束 |
1e-4 ~ 1e-2 | 常用范围 |
很大 | 权重被压到接近 0,模型欠拟合 |
用 AdamW,别用 Adam(weight_decay=...)
Adam 里的 weight_decay 实现有问题——衰减会被自适应学习率抵消掉一部分。
AdamW 把它单独拿出来做,才是你想要的效果。
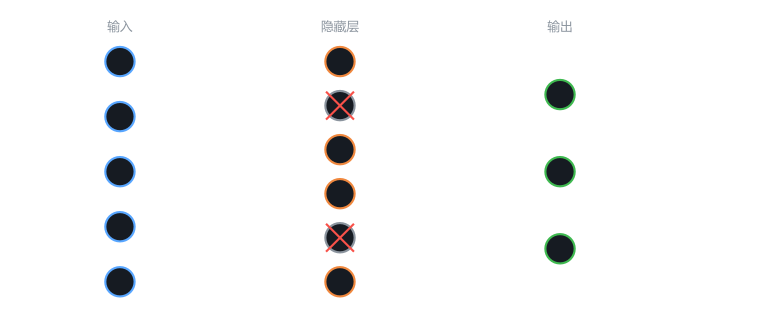
dropout
weight decay 约束的是权重大小。dropout 换了个思路:直接让网络变得不完整。
训练时随机把一部分神经元置零:
nn.Dropout(0.2) # 训练时每个神经元有 20% 概率被置零这样模型不能依赖某几个神经元,必须学出冗余的表达。
只有训练时生效
model.train() # Dropout 打开 model.eval() # Dropout 关闭这就是 train/eval 存在的意义之一
忘了 model.eval(),评估时 Dropout 还在丢神经元,准确率会随机波动,而且偏低。
反过来,忘了 model.train(),训练时没有 Dropout,等于没加正则。
放在哪
nn.Sequential( nn.Linear(784, 256), nn.ReLU(), nn.Dropout(0.2), # 激活之后 nn.Linear(256, 10), )常见是"线性 → 激活 → dropout"。
p 设多少
场景 | p |
|---|---|
全连接层 | 0.2 ~ 0.5 |
卷积层 | 0.1 ~ 0.2,或不用 |
输入层 | 0.1 ~ 0.2 |
输出层前 | 不用 |
早停
前面两个都要调参数。早停不用——它只是“该停的时候停”。
最简单也最有效:验证损失开始上升就停。
best = float("inf") patience = 5 wait = 0 for epoch in range(100): train_one_epoch() val = evaluate() if val < best: best = val wait = 0 torch.save(model.state_dict(), "best.pt") else: wait += 1 if wait >= patience: print("早停") break注意最后要用 best.pt,不是最后一轮的权重。
数据增强
上面三个都是在限制模型。数据增强反过来了:让训练数据变多。
对图像做随机变换,等于凭空造出新样本:
train_tf = transforms.Compose([ transforms.RandomHorizontalFlip(), transforms.RandomRotation(10), transforms.ColorJitter(0.2, 0.2), transforms.ToTensor(), ])这是 CV 里最有效的正则化,往往比 dropout 更管用。
增强要和任务匹配
猫狗分类可以水平翻转。数字识别不行——翻转后的 "6" 不是 "6"。
医学影像里左右翻转可能把病灶位置改变含义。
什么时候用什么
四种手段都讲完了,问题是该用哪个。
手段 | 成本 | 适用 |
|---|---|---|
早停 | 免费 | 永远开着 |
weight decay | 免费 | 几乎总是有用 |
dropout | 免费 | 全连接层多时 |
数据增强 | 耗 CPU | 图像/文本 |
减小模型 | 损失容量 | 过拟合很严重时 |
更多数据 | 贵 | 最根本的解法 |
顺序很重要
先确认是真过拟合(训练降、验证升),再上正则化。
如果两个都高,那是欠拟合,加正则化只会更差。
下一课
还有两个影响很大的东西:参数怎么初始化,以及批归一化。