一个训练项目该分几层
前面 8 课写的都是一个 .py 文件跑到底的代码。 几十行,够学习,不够用。
一旦要训第二种模型、要在别的数据集上重跑、要过一周回来接着训—— 单文件就开始塌了。这一章讲怎么把它拆开。
这一章和前面不一样
前面的课讲原理,这一章讲组织。
没有新概念,只有"同样的东西放在哪、谁负责调用谁"。
单文件会在什么时候崩
什么时候 | 会出什么事 |
|---|---|
想试第二种模型 | 复制一份文件改,两份代码从此各走各的 |
想改一个超参 | 在 300 行里找 |
过一周回来接着训 | 忘了上次用什么配置,只能从头再来 |
训练崩了想查原因 | 没有记录,只知道"效果不好" |
别人要看你的实验 | 发一堆 py 文件,对方不知道从哪开始跑 |
这些不是"代码写得丑",是结构上缺了东西。
按"谁负责什么"来分
不要按文件类型分(utils.py、helpers.py 这种),要按职责分:
cfg/ 配置:所有超参、路径、开关 model/ 模型:网络结构定义 + 按名字取模型的注册表 predata/ 数据:读文件、分词、建 Dataset、建 DataLoader load/ 编排:把上面这些装成一个能跑的对象 train/ 训练:循环、记录、保存、导出 save/ 产物:权重文件 logs/ 记录:TensorBoard、CSV 层 | 回答什么问题 | 不该出现什么 |
|---|---|---|
| 跑这次实验用什么参数 | 模型定义、训练逻辑 |
| 网络长什么样 | 数据加载、优化器 |
| 数据怎么变成张量 | 模型、训练 |
| 怎么把零件装上 | 具体的训练循环 |
| 一轮一轮怎么跑 | 网络结构定义 |
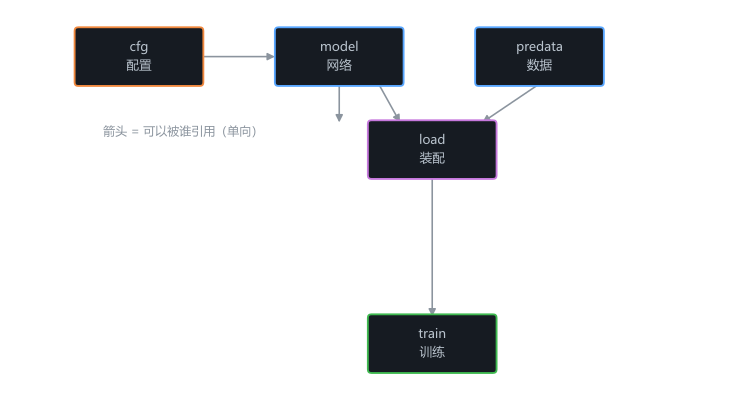
依赖方向是单向的
分好目录只是第一步。更关键的是谁可以引用谁——这条不能乱。
cfg ──► model ──► load ──► train │ ▲ │ └──► predata ──────────────┘ 箭头 = "可以被谁引用" 绝不能反向引用
model/ 里不许 import train/。
一旦反向引用,两个模块就绑死了:想单独测模型必须把训练代码也拖进来。
判断方法:这个文件能不能单独 import 而不触发别的东西。
一个真实项目的样子
上面的划分是抽象的。看一个真的在跑的项目怎么落地。
下面是实际在跑的项目目录,训练中英翻译用的:
pytorch/ ├── cfg/ │ └── build_cfg.py 配置类,装下所有超参 ├── model/ │ ├── model.py 所有网络结构 + get_model 注册表 │ ├── build.py 几个具体模型的定义 │ └── test.py ├── predata/ │ ├── load.py │ └── process.py 分词、编码、Dataset ├── load/ │ └── load.py LoadAll:把上面全装起来 ├── train/ │ ├── train_seqs.py 序列任务训练循环 │ ├── train_rnn.py │ └── out_onnx.py 导出 ONNX ├── save/ 权重文件(git 忽略) ├── logs/tensorboard/ 每次跑一个时间戳目录 └── main_ui/ Web 界面 + 用户系统 下面七课逐个拆开看。每一课都对着真实文件讲。
文件多了会不会乱
目录一多,新的问题来了:文件乱放。定几条规矩。
会。所以要定几条规矩:
规矩 | 为什么 |
|---|---|
一个文件只干一件事 | 看到 |
目录名就是职责名 | 不要 |
入口只有一个 | 别人拿到项目知道从哪个文件开始跑 |
产物不进 git |
|
# .gitignore save/ logs/ data/ __pycache__/ *.pth *.onnx先别急着拆
单文件写不动了再拆
不要一上来就搭这套目录。前面几课的代码就应该是一个文件。
拆分的成本是"改一个参数要看三个文件",只有在确实需要时才付这个成本。
判断标准:你开始复制粘贴同一个函数的时候,就该拆了。
下一课
第一个要拆出来的是配置——因为它被所有其他部分引用。