全连接处理图像的两个死穴
这一章要讲什么
前面八章建的网络,全是全连接层堆起来的。 拿它处理 MNIST 没问题——28×28 的灰度小图,784 个输入而已。
一旦换成真实照片,全连接立刻撑不住。这一章讲为什么,以及卷积怎么解决。
课 | 讲什么 |
|---|---|
这一课 | 全连接处理图像的参数爆炸和空间信息丢失 |
26.2 | 局部连接与权重共享——卷积的两个想法 |
26.3 | 习题 |
这一章不讲怎么算卷积(下一章讲)。只讲为什么非得是卷积。
死穴一:参数爆炸
MNIST 是 28×28 灰度图,拉平后 784 个输入。接一个 128 神经元的隐藏层:
import torch.nn as nn fc = nn.Linear(784, 128) print(sum(p.numel() for p in fc.parameters())) # 100480十万参数,训练一轮几秒钟。没问题。
换成一张普通的手机照片——224×224 彩色:
inp = 224 * 224 * 3 # 150528 fc = nn.Linear(inp, 1000) print(sum(p.numel() for p in fc.parameters())) # 150529000一亿五千万。还只是一层。
输入 | 元素数 | 接到 1000 个神经元的参数量 |
|---|---|---|
28×28 灰度 | 784 | 78 万 |
224×224 彩色 | 150528 | 1.5 亿 |
1024×1024 彩色 | 3145728 | 31 亿 |
31 亿参数,光存成 float32 就要 12.6 GB。还没开始训练,显存就没了。
乘积关系
全连接的参数量 = 输入元素数 × 输出神经元数。
图像边长翻倍,输入变 4 倍,参数也变 4 倍。
这就是为什么全连接网络在图像上走不远。
死穴二:丢掉了“谁挨着谁”
参数多还能靠加显存硬扛。第二个问题扛不了。
图像拉平成 784 个数字之后:
原来的 28×28: 拉平后: ┌─────────────┐ │ 像素(0,0) │ 像素(0,1) │ ... [像素(0,0), 像素(0,1), ..., 像素(27,27)] │ 像素(1,0) │ 像素(1,1) │ ... └─────────────┘ ↑ 上下相邻的像素 中间隔了 28 个位置空间关系全没了。全连接层看到的是一串数字, 对它来说“第 5 个”和“第 6 个”哪个是上下相邻、哪个是左右相邻,完全不知道。
而图像的绝大多数信息,就在“相邻”里。
图案 | 靠什么识别 |
|---|---|
一条竖边 | 左右相邻的像素亮度突变 |
一个角 | 一小片区域内的特定排列 |
一只猫耳朵 | 更大一片区域里的形状组合 |
这些都是局部的信息。全连接把这个结构彻底抹平了。
一个反例
如果你把一张图的像素随机打乱,再喂给全连接网络—— 它的表现几乎不变。
因为它本来就没在用空间结构。
同样的打乱喂给卷积网络,会直接失效。
卷积换了个思路
同一个任务——把 224×224×3 的图变成 1000 个分数——卷积这样做:
import torch.nn as nn conv = nn.Conv2d(3, 64, kernel_size=3, padding=1) print(sum(p.numel() for p in conv.parameters())) # 17921792 个参数。对比全连接的 1.5 亿,差了 84000 倍。
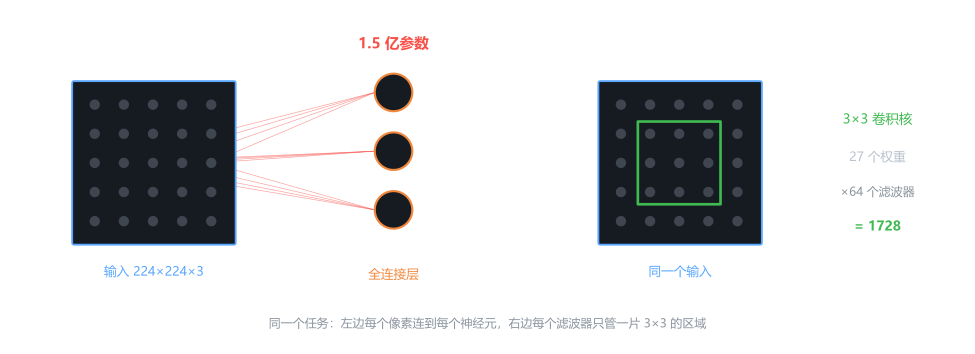
而且这个数字和图像大小无关:
big = nn.Conv2d(3, 64, kernel_size=3) # 用于 224×224 small = nn.Conv2d(3, 64, kernel_size=3) # 用于 32×32 print(sum(p.numel() for p in big.parameters())) # 1792 print(sum(p.numel() for p in small.parameters())) # 1792 一模一样这是卷积最核心的性质
参数数量和图像大小无关。
因为那 1792 个参数是一个小窗口里的权重, 它会被用到图像的每一个位置上——同一组权重反复用。
这就是下一课的第一件事:权重共享。
两个死穴各对应一个想法
死穴 | 卷积的对策 | 解决什么 |
|---|---|---|
参数爆炸 | 权重共享:一个 3×3 窗口扫全图,权重不变 | 参数量与图像大小解耦 |
丢失空间结构 | 局部连接:每个输出只看一小片相邻区域 | 保留“谁挨着谁” |
下一课把这两个想法拆开看。
下一课
参数少了八万倍、还保住了空间结构——这两件事分别是怎么做到的?