LeNet:第一个真正跑起来的卷积网络
这一课在哪
前面三章把零件讲完了:卷积怎么算(第 26 章)、 步长填充池化怎么调(第 27 章)。
现在第一次把它们串成一个完整的网络。
之前 | 这一课 | 下一课 |
|---|---|---|
卷积、池化各自怎么算 | 怎么排成一条链 | 敲成代码、训练 |
1989 年那件事
Yann LeCun,AT&T 贝尔实验室。他做了一个网络,用来认手写数字, 给它起名叫 LeNet。
这件事的分量不在于「第一个卷积网络」,而在于: 它是第一篇用反向传播成功训练出来的卷积网络。
问题 | 他解决了什么 |
|---|---|
卷积层能提特征——这在 1980 年代就知道了 | 但怎么训练?权重从哪来? |
反向传播——1986 年就有了 | 但没人把它成功接到卷积层上 |
LeNet | 把这两件事接起来了 |
当年它的性能和支持向量机(SVM)相当, 而 SVM 是那个年代的主流方法。
它不只是论文里的东西
LeNet 被装进了自动取款机,用来识别支票上的数字。
一个很难忘的事实
1990 年代写的那些代码,有一些自动取款机今天还在跑。
你手上的手机比它快几万倍,但那个网络结构还在某个地方认支票号码。
这是这一章值得认真看的原因——它不是一个过时的练习,是一个活着的系统。
除了支票,它还读过邮编和别的数字串。
它分成两半
整张网络只有两部分,这个分法一直用到今天:
部分 | 干什么 | 由什么组成 |
|---|---|---|
卷积编码器 | 把图变成「这里有没有某种图案」 | 2 个卷积层 |
全连接密集块 | 拿这些图案判类别 | 3 个全连接层 |
记住这个分法
编码器负责「看懂」,分类头负责「下结论」。
后面 AlexNet、VGG、ResNet 全是这个结构,只是编码器越来越长。
看到任何 CNN,先找这条分界线——它通常在「拉平」那一步。
形状怎么变
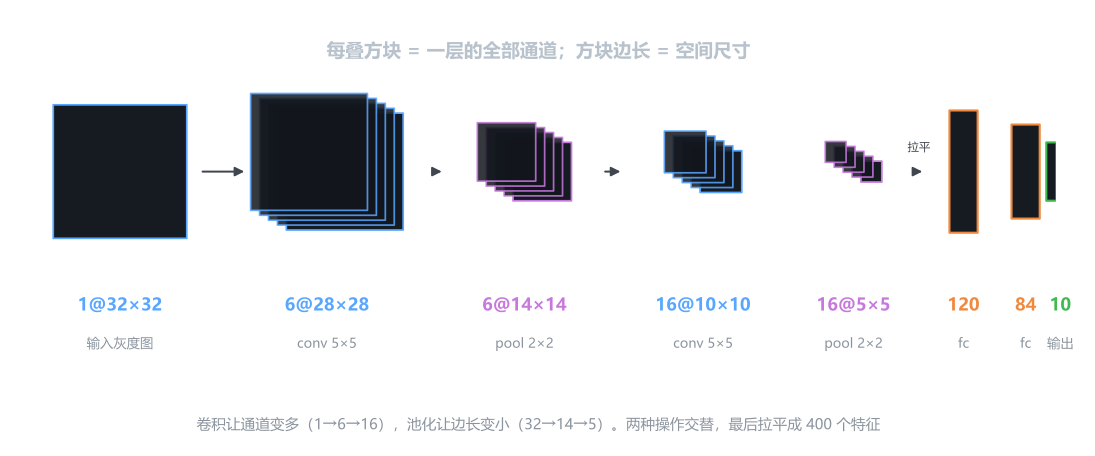
从 28×28 的灰度图到 10 个数,一共七层:
层 | 操作 | 输出形状 | 边长怎么算 |
|---|---|---|---|
C1 | 5×5 卷积,6 个核,padding=2 | 6@28×28 | 28 + 4 − 5 + 1 |
S2 | 2×2 平均池化,步长 2 | 6@14×14 | 28 ÷ 2 |
C3 | 5×5 卷积,16 个核,不补边 | 16@10×10 | 14 − 5 + 1 |
S4 | 2×2 平均池化,步长 2 | 16@5×5 | 10 ÷ 2 |
F5 | 拉平后全连接 | 120 | 16×5×5 = 400 |
F6 | 全连接 | 84 | — |
F7 | 全连接 | 10 | — |
为什么第一个卷积要补 2 圈
这是整张图最容易被忽略的一处设计。
5×5 的卷积核扫一遍,会让边长少 4。如果第一层就不补边, 28 直接变 24——图一开始就掉了一大块。
做法 | 第一层输出 | 一路走完 | 拉平后 |
|---|---|---|---|
不补边 | 6@24×24 | 24 → 12 → 8 → 4 | 16×4×4 = 256 |
补 2 圈 | 6@28×28 | 28 → 14 → 10 → 5 | 16×5×5 = 400 |
所以 LeNet 的 padding=2 不是随手写的—— 它把第一层的尺寸保住了,让后面的链条刚好落到 5×5。
只有第一层补,第二层不补
第一层 padding=2,第二层没有 padding。
为什么?因为第一层要保住尺寸; 第二层要主动缩小——14 变 10,正好够接池化。
补边不是「越多越好」,是按需。
为什么用 sigmoid 和平均池化
你可能会问:现在不是都用 ReLU 和最大池化吗?
因为 1989 年还没有
LeNet 用的是 sigmoid 激活和平均池化。
不是他觉得这两个更好——是 ReLU 和最大池化那时候还没被提出来。
后来大家发现 ReLU 和最大池化更有效,所以现代网络全换了。 但结构本身没变。
两个激活函数的差别
import torch x = torch.tensor([-2.0, -1.0, 0.0, 1.0, 2.0]) print(torch.sigmoid(x)) # tensor([0.1192, 0.2689, 0.5000, 0.7311, 0.8808]) 永远在 (0,1) print(torch.relu(x)) # tensor([0., 0., 0., 1., 2.]) 负数直接归零sigmoid | ReLU | |
|---|---|---|
输出范围 | (0, 1) | [0, +∞) |
输入 -2 时 | 0.119(还有输出) | 0(完全关掉) |
梯度最大 | 0.25 | 1 |
深层会不会消失 | 会,连乘 0.25 | 好很多 |
梯度最大 0.25 这一条,就是第 34 章 LSTM 要解决的那个问题的源头之一。
数参数
七层一共多少个参数?
import torch.nn as nn def count(layer): return sum(p.numel() for p in layer.parameters()) layers = [ ("C1 conv 1→6, 5×5", nn.Conv2d(1, 6, 5, padding=2)), ("C3 conv 6→16, 5×5", nn.Conv2d(6, 16, 5)), ("F5 fc 400→120", nn.Linear(400, 120)), ("F6 fc 120→84", nn.Linear(120, 84)), ("F7 fc 84→10", nn.Linear(84, 10)), ] total = 0 for name, layer in layers: n = count(layer) total += n print(f"{name:<22} {n:>7,}") print(f"{'合计':<22} {total:>7,}")C1 conv 1→6, 5×5 156 C3 conv 6→16, 5×5 2,416 F5 fc 400→120 48,120 F6 fc 120→84 10,164 F7 fc 84→10 850 合计 61,706参数都堆在哪
部分 | 参数 | 占比 |
|---|---|---|
卷积编码器(C1+C3) | 2,572 | 4.2% |
全连接分类头(F5+F6+F7) | 59,134 | 95.8% |
这个比例会一直跟着你
卷积层提特征,但几乎不花参数;全连接层做分类,却吃掉了 96%。
后面三章你会看到这个数字反复出现:VGG 是 93%,AlexNet 是 96%。
第 30 章 NiN 就是专门来砍这一块的。
为什么卷积这么省?因为权重共享—— 5×5=25 个权重扫全图,不管图多大都是这 25 个。
为什么全连接这么费?因为 400 × 120 = 48000, 每一个连接一个独立权重。
这一课留下的四个数
数 | 值 | 含义 |
|---|---|---|
1989 | — | LeCun 在贝尔实验室做出来 |
28 → 5 | — | 空间尺寸缩了 5.6 倍 |
1 → 16 | — | 通道涨了 16 倍 |
16×5×5 | 400 | 拉平后的长度 |
参数 | 61,706 | 96% 在分类头 |
下一课
结构看懂了。下一课敲成代码跑一遍—— 用 d2l 这个版本(28×28 输入 + conv1 补 2 圈),训三轮看准确率。