完整代码:ResNet18 微调猫狗分类
这一课在哪
前两课讲了原理和零件。这一课把它们拼成一个能直接跑的脚本, 并且跑出真实结果。
验收项 | 标准 |
|---|---|
数据 | 1000 张猫狗,70/15/15 |
冻结版可训练参数 | 1,026 |
冻结版测试准确率 | 100.00% |
全训版测试准确率 | 97.33% |
数据
from pathlib import Path from PIL import Image from torch.utils.data import Dataset, DataLoader from torchvision import transforms class Animals(Dataset): def __init__(self, files, labels, transform): self.files = files self.labels = labels self.transform = transform def __len__(self): return len(self.files) def __getitem__(self, index): with Image.open(self.files[index]) as img: image = self.transform(img.convert("RGB")) return image, self.labels[index]扫描目录、打乱、切分:
import random source = Path("D:/main/archive/animals") files, labels = [], [] for index, name in enumerate(["cat", "dog"]): for path in sorted((source / name).iterdir()): if path.suffix.lower() in (".png", ".jpg", ".jpeg"): files.append(path) labels.append(index) random.seed(0) order = list(range(len(files))) random.shuffle(order) n = len(order) n_train = int(n * 0.70) n_val = int(n * 0.15) train_idx = order[:n_train] val_idx = order[n_train:n_train + n_val] test_idx = order[n_train + n_val:]标准化必须用 ImageNet 的那一套
这里是预训练模型,不是从零训。
预训练时用的均值和方差是 ImageNet 的统计量, 微调时必须用同一套,否则激活值分布对不上。
尺寸也必须是 224×224——ResNet 就是在这个尺寸上学的。
mean = (0.485, 0.456, 0.406) std = (0.229, 0.224, 0.225) train_transform = transforms.Compose([ transforms.Resize((224, 224)), transforms.RandomHorizontalFlip(), transforms.ToTensor(), transforms.Normalize(mean=mean, std=std), ]) eval_transform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize(mean=mean, std=std), ]) def make_set(indices, transform): return Animals( files=[files[i] for i in indices], labels=[labels[i] for i in indices], transform=transform, ) train_set = make_set(train_idx, train_transform) val_set = make_set(val_idx, eval_transform) test_set = make_set(test_idx, eval_transform) train_loader = DataLoader(train_set, batch_size=16, shuffle=True) val_loader = DataLoader(val_set, batch_size=32) test_loader = DataLoader(test_set, batch_size=32)模型:冻结 + 换头
import torch import torch.nn as nn import torchvision.models as models def build_model(freeze_backbone=True, num_classes=2): net = models.resnet18(weights=models.ResNet18_Weights.DEFAULT) if freeze_backbone: for param in net.parameters(): param.requires_grad = False net.fc = nn.Linear(in_features=512, out_features=num_classes) return net device = "cuda" if torch.cuda.is_available() else "cpu" model = build_model(freeze_backbone=True).to(device) def count_trainable(m): return sum(p.numel() for p in m.parameters() if p.requires_grad) print(count_trainable(model)) # 1,026训练
loss_fn = nn.CrossEntropyLoss() trainable = [p for p in model.parameters() if p.requires_grad] optimizer = torch.optim.Adam(trainable, lr=1e-3) for epoch in range(1, 7): model.train() train_loss, seen, train_correct = 0.0, 0, 0 for images, targets in train_loader: images = images.to(device) targets = targets.to(device) logits = model(images) loss = loss_fn(logits, targets) optimizer.zero_grad() loss.backward() optimizer.step() train_loss += loss.item() * targets.size(0) seen += targets.size(0) train_correct += (logits.argmax(dim=1) == targets).sum().item() model.eval() val_correct, val_seen = 0, 0 with torch.no_grad(): for images, targets in val_loader: images = images.to(device) targets = targets.to(device) val_correct += (model(images).argmax(dim=1) == targets).sum().item() val_seen += targets.size(0) print( f"{epoch} loss {train_loss/seen:.4f} " f"train {100*train_correct/seen:.2f}% " f"val {100*val_correct/val_seen:.2f}%" )真实跑出来(RTX 5060,每轮 22 秒):
1 loss 0.2181 train 93.14% val 100.00% 2 loss 0.0460 train 99.43% val 100.00% 3 loss 0.0382 train 99.43% val 100.00% 4 loss 0.0229 train 99.71% val 100.00% 5 loss 0.0277 train 99.57% val 100.00% 6 loss 0.0232 train 99.57% val 100.00%第一轮验证就到 100%
只训了 1,026 个参数,一轮就满分。
因为前面 20 层是 ImageNet 上训好的,它们已经会「看图」了—— 你只需要教它「猫和狗的区别在哪」。
测试集
model.eval() correct, total = 0, 0 with torch.no_grad(): for images, targets in test_loader: images = images.to(device) targets = targets.to(device) correct += (model(images).argmax(dim=1) == targets).sum().item() total += targets.size(0) print(f"测试集 {100 * correct / total:.2f}%")测试集 100.00%对照:全部层都训
把 freeze_backbone 改成 False,其余不动:
model = build_model(freeze_backbone=False).to(device) print(count_trainable(model)) # 11,177,5381 loss 0.1012 train 95.71% val 90.00% 2 loss 0.0252 train 98.57% val 99.33% 3 loss 0.0359 train 99.29% val 97.33% 4 loss 0.0439 train 98.57% val 87.33% 5 loss 0.0987 train 96.57% val 91.33% 6 loss 0.0565 train 98.00% val 96.67% 测试集 97.33%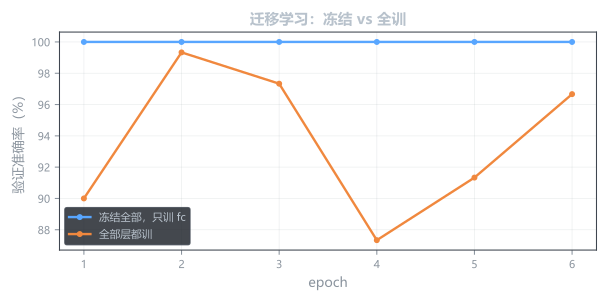
结果对比
方案 | 可训练参数 | 最好验证 | 测试集 |
|---|---|---|---|
冻结,只训 fc | 1,026 | 100.00% | 100.00% |
全部层都训 | 11,177,538 | 99.33% | 97.33% |
为什么训得少反而更准
因为数据只有 700 张。
11 亿个参数去学 700 张图,一定会把训练集背下来—— 训练准确率 98%,验证准确率在 87~99% 之间乱跳。
1026 个参数没能力背,只能学「猫和狗最本质的区别」, 反而泛化得更好。
全训版验证曲线为什么抖
87.33% → 99.33% → 97.33% → 87.33% → 91.33% → 96.67%。
两个原因:
原因 | 说明 |
|---|---|
验证集只有 150 张 | 错 2 张就是 1.3% |
BatchNorm 统计量在变 | 所有层都在训,BN 的滑动平均每轮都在更新 |
冻结版就没这个问题——所有 BN 层都冻住了,统计量固定, 所以稳定在 100%。
和从零训对比
做法 | 参数量 | 训练轮数 | 测试准确率 |
|---|---|---|---|
从零训 ResNet(第 31 章) | 2,795,554 | 20 | 98.00% |
微调 ResNet18 | 1,026 可训练 | 6 | 100.00% |
这就是迁移学习的价值
从零训:280 万参数、20 轮、98%。
微调:1026 个可训练参数、6 轮、100%。
训练时间从 8 分钟降到 2 分钟,效果还更好。
整段代码
合并起来,能直接跑:
import random from pathlib import Path import torch import torch.nn as nn import torchvision.models as models from PIL import Image from torch.utils.data import Dataset, DataLoader from torchvision import transforms # ── 1. 数据集 ────────────────────────────── class Animals(Dataset): def __init__(self, files, labels, transform): self.files = files self.labels = labels self.transform = transform def __len__(self): return len(self.files) def __getitem__(self, index): with Image.open(self.files[index]) as img: image = self.transform(img.convert("RGB")) return image, self.labels[index] source = Path("D:/main/archive/animals") files, labels = [], [] for index, name in enumerate(["cat", "dog"]): for path in sorted((source / name).iterdir()): if path.suffix.lower() in (".png", ".jpg", ".jpeg"): files.append(path) labels.append(index) random.seed(0) order = list(range(len(files))) random.shuffle(order) n = len(order) n_train = int(n * 0.70) n_val = int(n * 0.15) mean = (0.485, 0.456, 0.406) std = (0.229, 0.224, 0.225) train_tf = transforms.Compose([ transforms.Resize((224, 224)), transforms.RandomHorizontalFlip(), transforms.ToTensor(), transforms.Normalize(mean, std), ]) eval_tf = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize(mean, std), ]) def make_set(idx, tf): return Animals([files[i] for i in idx], [labels[i] for i in idx], tf) train_set = make_set(order[:n_train], train_tf) val_set = make_set(order[n_train:n_train + n_val], eval_tf) test_set = make_set(order[n_train + n_val:], eval_tf) train_loader = DataLoader(train_set, batch_size=16, shuffle=True) val_loader = DataLoader(val_set, batch_size=32) test_loader = DataLoader(test_set, batch_size=32) # ── 2. 模型 ──────────────────────────────── def build_model(freeze_backbone=True, num_classes=2): net = models.resnet18(weights=models.ResNet18_Weights.DEFAULT) if freeze_backbone: for param in net.parameters(): param.requires_grad = False net.fc = nn.Linear(in_features=512, out_features=num_classes) return net device = "cuda" if torch.cuda.is_available() else "cpu" model = build_model(freeze_backbone=True).to(device) # ── 3. 训练 ──────────────────────────────── loss_fn = nn.CrossEntropyLoss() trainable = [p for p in model.parameters() if p.requires_grad] optimizer = torch.optim.Adam(trainable, lr=1e-3) for epoch in range(1, 7): model.train() for images, targets in train_loader: images = images.to(device) targets = targets.to(device) logits = model(images) loss = loss_fn(logits, targets) optimizer.zero_grad() loss.backward() optimizer.step() model.eval() correct, total = 0, 0 with torch.no_grad(): for images, targets in val_loader: images = images.to(device) targets = targets.to(device) correct += (model(images).argmax(dim=1) == targets).sum().item() total += targets.size(0) print(f"{epoch} val {100*correct/total:.2f}%") # ── 4. 测试 ──────────────────────────────── model.eval() correct, total = 0, 0 with torch.no_grad(): for images, targets in test_loader: images = images.to(device) targets = targets.to(device) correct += (model(images).argmax(dim=1) == targets).sum().item() total += targets.size(0) print(f"测试集 {100*correct/total:.2f}%")下一课
习题:数可训练参数、判断该冻哪几层、踩标准化的坑。