RNN 是什么:h 的传递
这一课在哪
上一课说了 RNN 要「带记忆」,用一个变量 h 存。
这一课把 h 拆开:它是什么、怎么算出来、为什么说它 就是一个全连接层加了个循环。
先看全局:展开图
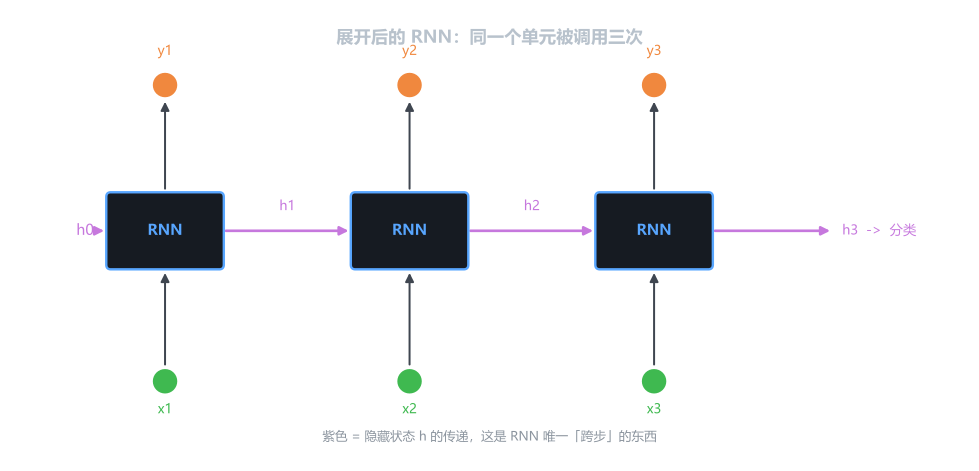
这张图里有三件事:
看哪里 | 含义 |
|---|---|
三个蓝色方块 | 是同一个单元,不是三个不同的网络 |
紫色横线 |
|
绿色 → 蓝色 → 橙色 | 输入 → 隐藏状态 → 输出 |
只有一个单元
图里画了三个方块,看起来像三个网络。实际只有一个。
把它「展开」只是为了看清信息怎么流动—— 就像把 for i in range(3) 的循环展开成三行。
再看单个单元:循环在哪
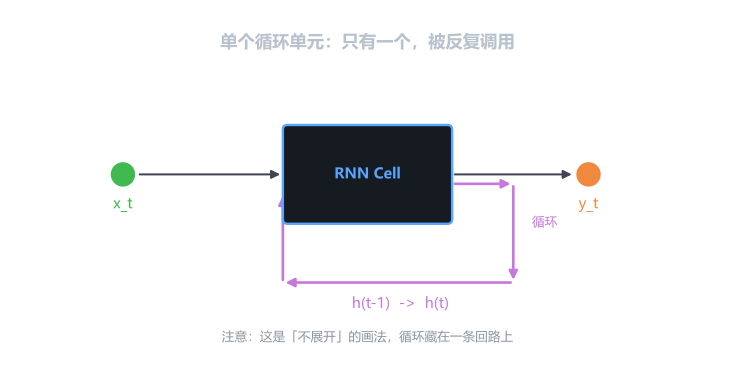
这一张和不展开那张是同一件事。区别只是:
画法 | 适合看什么 |
|---|---|
单个单元(本图) | 看清楚结构本身——只有一组权重 |
展开图(上一张) | 看清楚信息怎么一步步传 |
h 到底是什么
h 就是一个向量——一串数,长度由你定(比如 64)。
它没有特别的物理含义。训练之前是随机的,训练之后变成了 「对当前上下文的一个压缩表示」。
import torch import torch.nn as nn rnn = nn.RNN(input_size=100, hidden_size=64, batch_first=True) x = torch.randn(4, 10, 100) # 4 个句子,每个 10 个词,每个词 100 维 out, h_n = rnn(x) print(out.shape) # torch.Size([4, 10, 64]) 每一步的输出 print(h_n.shape) # torch.Size([1, 4, 64]) 最后一步的 h变量 | 形状 | 是什么 |
|---|---|---|
|
| 最后一步的 |
|
| 每一步的 |
h_n 其实就是 out[:, -1, :]—— 最后那一步的输出。
核心:h 怎么算出来
这是整章最重要的一个公式:
拆开看,只有四样东西:
符号 | 是什么 | 形状 |
|---|---|---|
这一步的输入 |
| |
上一步的记忆 |
| |
输入的权重 |
| |
记忆的权重 |
| |
偏置 |
|
为什么说它是「全连接层加了循环」
先看普通全连接层:
再看 RNN:
就是多了一项 。 这一项把上一步的输出接回来当输入—— 所以叫「循环」。
把 去掉,它就退化成普通全连接层。
参数量
从公式直接数:
input_size = 100 hidden_size = 64 w_xh = hidden_size * input_size # 64 × 100 w_hh = hidden_size * hidden_size # 64 × 64 bias = hidden_size # 64 print(w_xh + w_hh + bias) # 10,560和句子长度无关——这是权重共享的直接结果。
输出怎么来
有些任务要每一步都输出(词性标注),有些只要最后一步(情感分析)。
任务 | 用哪些 |
|---|---|
词性标注 | 全部 |
情感分析 | 只用 |
翻译 | 另一套结构(第 37 章) |
手算一次
用最小的数字跑一遍,看清楚每一步。输入 2 维、隐藏 2 维。
x1 = [1, 0] x2 = [0, 1] W_xh = [[1, 0], [0, 1]] 单位矩阵,输入直接传过去 W_hh = [[0, 1], [1, 0]] 交换两个分量 b = [0, 0] h0 = [0, 0]第 1 步
第 2 步
输入换成了 ,记忆是上一步的 :
步 | 输入 | 加和 | ||
|---|---|---|---|---|
1 | [1, 0] | [0, 0] | [1, 0] | [0.7616, 0] |
2 | [0, 1] | [0, 0.7616] | [0, 1.7616] | [0, 0.9428] |
第 2 步那一列是关键
第 2 步的「加和」是 ,比输入 大。
多出来的 0.7616 就是第 1 步的记忆。
这就是「带记忆」的字面含义——上一步的东西真的加进来了。
用 PyTorch 核对
import torch import torch.nn as nn rnn = nn.RNN(input_size=2, hidden_size=2, batch_first=True) with torch.no_grad(): rnn.weight_ih_l0.copy_(torch.tensor([[1.0, 0.0], [0.0, 1.0]])) rnn.weight_hh_l0.copy_(torch.tensor([[0.0, 1.0], [1.0, 0.0]])) rnn.bias_ih_l0.zero_() rnn.bias_hh_l0.zero_() x = torch.tensor([[[1.0, 0.0], [0.0, 1.0]]]) out, h_n = rnn(x) print(out) # tensor([[[0.7616, 0.0000], # [0.0000, 0.9428]]], grad_fn=...) print(h_n) # tensor([[[0.0000, 0.9428]]], grad_fn=...)bias 有两个
PyTorch 把偏置拆成了 bias_ih_l0 和 bias_hh_l0 两个, 各一个 hidden_size 长的向量。
加起来才等于公式里的那个 。所以参数量是 。
tanh 为什么在这
把任意实数压到 。
import torch x = torch.tensor([-10.0, -1.0, 0.0, 1.0, 10.0]) print(torch.tanh(x)) # tensor([-1.0000, -0.7616, 0.0000, 0.7616, 1.0000])没有它 | 有它 |
|---|---|
| 始终在 之间 |
无法训练 | 数值稳定 |
但也正因为这个「压扁」,它也是梯度消失的帮凶—— 导数最大只有 1,连乘几十次就没了。第 34 章的 LSTM 就是来修这个的。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
参数量 | 10,560 | ,和句子长度无关 |
h 的形状 |
| 每句一个,不是每词一个 |
手算第 2 步 | [0, 1.7616] | 多出来的 0.7616 是上一步的记忆 |
下一课
公式清楚了。但 是什么?一个词怎么变成一个向量?
下一课讲 embedding——把词变成向量的那一步。