GRU:把三个门压成两个
这一课在哪
LSTM 有三个门、两个状态(h 和 C),参数是 RNN 的 4 倍。
GRU 是它的精简版:两个门、一个状态。
LSTM | GRU | |
|---|---|---|
门 | 遗忘 / 输入 / 输出 + 候选 | 重置 / 更新 |
状态 | h 和 C | 只有 h |
参数(128→64) | 49,664 | 37,248 |
去掉的是哪两样
GRU 砍掉了两样东西,都有道理:
砍掉 | 理由 |
|---|---|
单独的 C | h 兼任记忆。 |
输出门 | 没有 C 就没有「从 C 里读多少」这回事 |
输入门 + 遗忘门 | 合并成一个更新门——两者加起来正好是 1 |
最后一条是关键洞察
LSTM 里,遗忘和写入是两件独立的事, 两个门各算各的。
但「忘记多少」和「写多少」其实是一件事的两面—— 忘了 30% 就等于腾出 30% 的位置。
GRU 用一个门 同时表示: 留 ,写 。
结构长什么样
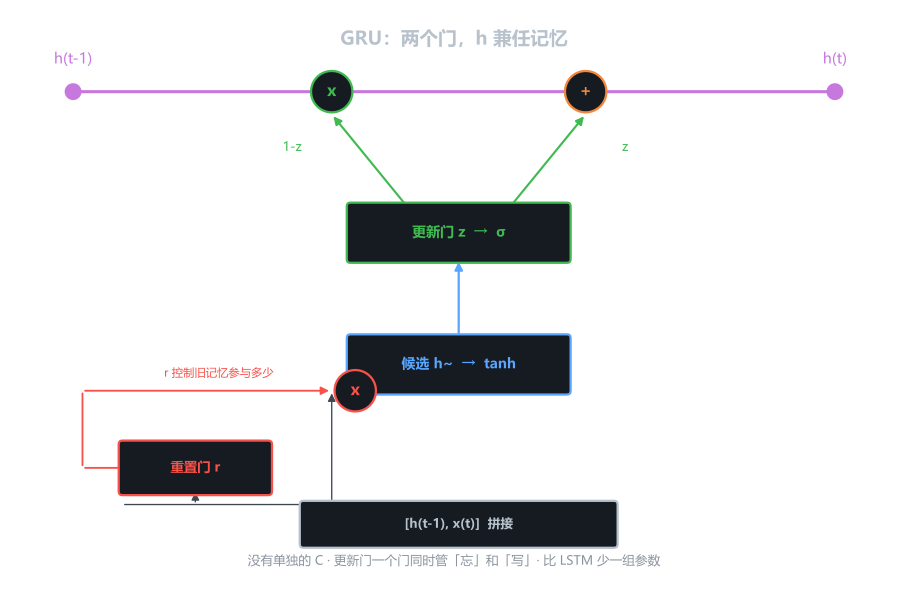
两个门:
门 | 回答什么 |
|---|---|
重置门 | 算候选时,旧的记忆参考多少 |
更新门 | 新状态里,旧的留多少(剩下的给新的) |
三个公式
看第二行和第四行,是一对:
门的值 | 新状态 h 里 |
|---|---|
全是旧的,新信息被忽略 | |
全新内容,旧记忆不参与 | |
各一半 |
这叫凸组合:两个系数加起来恒等于 1,结果是两者的加权平均。
z 接近 1 意味着「跳过一个时间步」
时 , 这一步的输入 基本被忽略。
相当于在依赖链条上跳过了第 t 步。
这正是解决长距离依赖的机制——不需要处理的信息就整步跳过, 梯度也就原样传过去了。
重置门在干什么
它在算候选之前起作用: 。
意思 | 什么时候有用 | |
|---|---|---|
接近 1 | 旧记忆全参与 | 新内容和前文有关 |
接近 0 | 旧记忆不参与 | 新内容是一个全新的开头, |
举个例子:读到一个新的句号,后面是另一句话了。 重置门可以关掉,把上一句的记忆挡在候选之外。
和 LSTM 的对照
LSTM 里这个作用是遗忘门干的(作用在 C 上)。
GRU 里分成两个:重置门作用在候选的计算上, 更新门作用在最后的混合上。
一个管「算的时候参考多少」,一个管「最后留多少」。
数参数
import torch.nn as nn for name, net in [ ("RNN", nn.RNN(128, 64, batch_first=True)), ("GRU", nn.GRU(128, 64, batch_first=True)), ("LSTM", nn.LSTM(128, 64, batch_first=True)), ]: print(f"{name:<5} {sum(p.numel() for p in net.parameters()):>7,}")RNN 12,416 GRU 37,248 LSTM 49,664网络 | 公式 | 参数 |
|---|---|---|
RNN | 1 组 | 12,416 |
GRU | 3 组(r, z, 候选) | 37,248 |
LSTM | 4 组(f, i, g, o) | 49,664 |
GRU 比 LSTM 少 25%,比 RNN 多 3 倍。
gru = nn.GRU(128, 64, batch_first=True) print(gru.weight_ih_l0.shape) # torch.Size([192, 128]) print(gru.weight_hh_l0.shape) # torch.Size([192, 64])192 = 3 × 64——三个门叠在一起,和 LSTM 的 256 = 4 × 64 一个道理。
用起来什么差别
import torch x = torch.randn(4, 10, 128) rnn = nn.RNN(128, 64, batch_first=True) gru = nn.GRU(128, 64, batch_first=True) lstm = nn.LSTM(128, 64, batch_first=True) print(rnn(x)[1].shape) # torch.Size([1, 4, 64]) print(gru(x)[1].shape) # torch.Size([1, 4, 64]) print(lstm(x)[1][0].shape) # torch.Size([1, 4, 64]) ← 多一层层 | 返回值 | 怎么取最后一步 |
|---|---|---|
|
|
|
|
|
|
|
|
|
这个坑我踩过
写 _, h = self.rnn(packed) 时:
RNN/GRU 的 h 是 (1, B, H),h[0] 就对了。
LSTM 的 h 是元组 (h_n, c_n), h[0] 拿到的是 h_n(还是三维), 还要再 [0] 一次。
不拆的话报错是 Expected input batch_size (1) to match target batch_size (64)。
正确写法
_, h = self.rnn(packed) if self.kind == "lstm": h_n, _c_n = h last = h_n[0] else: last = h[0]怎么选
情况 | 建议 |
|---|---|
不知道选哪个 | 先试 GRU,参数少、通常不差 |
很长的序列(几百步以上) | LSTM 的 C 通道更干净 |
显存紧 | GRU |
要极致效果 | 两个都跑,看验证集 |
下一课会用真实数据对比这三个网络,结果有点出乎意料。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
GRU 参数 | 37,248 | 比 LSTM 少 25% |
|
| 3 个门 × 64 |
门的总数 | 2 | 重置 + 更新 |
下一课
结构都讲完了。下一课看代码上怎么从 RNN 改成 LSTM/GRU—— 只改两行,但有一个返回值上的坑。