推理:贪心与束搜索
这一课在哪
训练完了。真正用的时候没有标准答案可喂—— 解码器必须自己往下猜。
猜法有好几种,效果差得不小。这一课讲两种,并且实测对比。
推理和训练,就差一行
# 训练时 word = tgt[:, t] # 喂标准答案 # 推理时 word = logits.argmax(dim=1) # 喂自己刚猜的这一行改了之后,就变成自回归生成: 上一步的输出,当成下一步的输入。
还要知道什么时候停
for step in range(max_len): logits, state = decoder.step(word, state) next_id = logits.argmax(dim=1) if next_id.item() == EOS: # 吐出 <eos> 就停 break output.append(next_id.item()) word = next_id必须有 max_len 兜底
模型不一定学会吐 <eos>。
训练不够时它可能一直生成下去,或者反复输出同一个词。
所以要设一个上限(这里 25),到了就强制停。
贪心解码
每一步都取概率最大的那个词。最容易想到,也最快。
def greedy_decode(model, src_ids, max_len=25): model.eval() with torch.no_grad(): src = torch.tensor([src_ids]).to(device) src_len = torch.tensor([len(src_ids)]) _, hidden = model.encoder(src, src_len) state = hidden.squeeze(0) word = torch.tensor([BOS]).to(device) output = [] for _ in range(max_len): logits, state = model.decoder.step(word, state) next_id = int(logits.argmax(dim=-1)) if next_id == EOS: break output.append(next_id) word = torch.tensor([next_id]).to(device) return output贪心的问题
每一步都选最好的,不等于整句最好。
第 1 步:选「我」 概率 0.6 ← 当前最高 第 2 步:选「的」 概率 0.5 整句概率 0.6 × 0.5 = 0.30 但如果第 1 步选「咱」(概率 0.3),后面可能接: 第 2 步:选「们」 概率 0.9 整句概率 0.3 × 0.9 = 0.27 ——这个例子还不明显,但真实情况里差距会很大贪心为什么不是最优
假设正确译文是「我会讲英语」。
第 1 步如果「我」的概率是 0.7,「俺」是 0.2,贪心选「我」,对了。
但第 2 步可能「我 去」的概率比「我 会」高一点点, 贪心选了「去」,整句就跑偏了。
贪心只看一步,看不到后面。
束搜索
思路:同时保留 k 条候选路径,每一步都扩展它们,最后挑最好的。
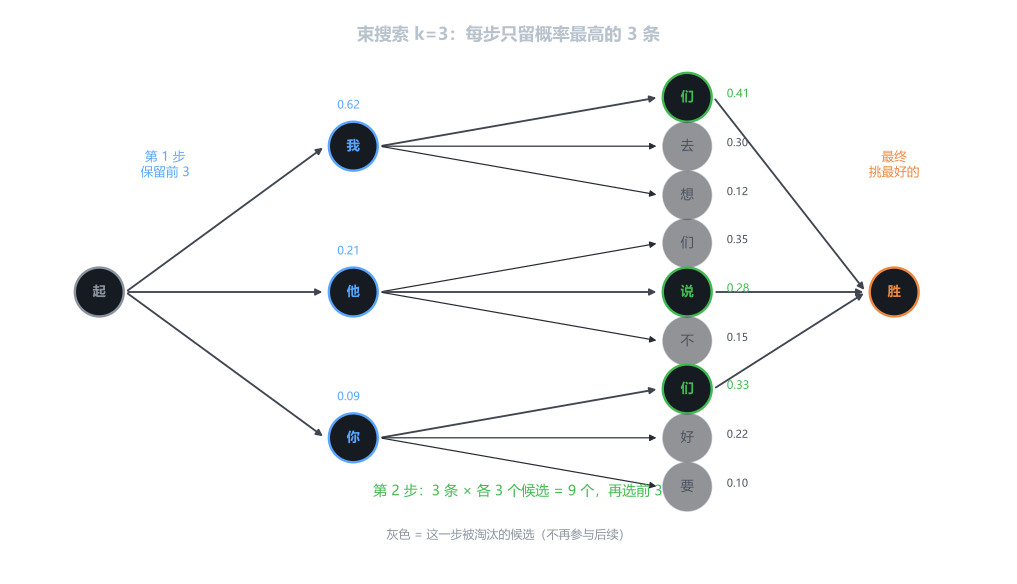
def beam_search(model, src_ids, k=5, max_len=25): model.eval() with torch.no_grad(): src = torch.tensor([src_ids]).to(device) src_len = torch.tensor([len(src_ids)]) _, hidden = model.encoder(src, src_len) state0 = hidden.squeeze(0) # 每条候选:(已生成的词, 当前状态, 累计对数概率) beams = [([], state0, 0.0)] finished = [] for _ in range(max_len): candidates = [] for seq, state, logp in beams: word = BOS if not seq else seq[-1] word = torch.tensor([word]).to(device) logits, new_state = model.decoder.step(word, state) log_probs = torch.log_softmax(logits, dim=-1)[0] top = torch.topk(log_probs, k) for value, idx in zip(top.values.tolist(), top.indices.tolist()): if idx == EOS: finished.append((seq, logp + value)) else: candidates.append((seq + [idx], new_state, logp + value)) if not candidates: break candidates.sort(key=lambda x: -x[2]) beams = candidates[:k] if not finished: finished = [(seq, logp) for seq, _, logp in beams] finished.sort(key=lambda x: -(x[1] / max(1, len(x[0])))) return finished[0][0]行 | 为什么 |
|---|---|
| 概率连乘会下溢,取对数变成加法 |
| 只留前 k 条,不然候选会指数爆炸 |
| 遇到 |
| 除以长度,不然总是偏向短句 |
最后那个「除以长度」很重要
对数概率都是负数,越长越负。
不除长度的话,束搜索会一直偏好最短的候选, 经常输出一两个词就结束。
这叫「长度惩罚」,是束搜索必须处理的细节。
实测对比
同一份测试集,取 200 句,用第 35.6 课那个 hidden=256 的模型:
方法 耗时 BLEU 贪心 2.4s 7.23 束搜索 k=5 27.6s 10.45 慢 11.5 倍方法 | 耗时 | BLEU | 相对 |
|---|---|---|---|
贪心 | 2.4s | 7.23 | 1× |
束搜索 k=5 | 27.6s | 10.45 | BLEU +45%,慢 11.5× |
束搜索确实有用,但很贵
BLEU 从 7.23 提到 10.45,提升 45%。
代价是慢 11.5 倍——因为每步要跑 5 次,而且 5 条路径都要各自维护状态。
所以线上系统通常用 k=3~5,离线批量翻译才用更大的 k。
看几个例子
英: i can speak english. 金: 我会讲英语。 贪: 我会讲英语。 ← 全对 束: 我会讲英语。 ← 全对 英: who does this suitcase belong to? 金: 这个手提箱是谁的? 贪: 这是谁的铅笔? ← 句式对,名词错 束: 这个词组是谁的? ← 更差 英: tell tom i need to borrow his car. 金: 告诉汤姆我需要借他的车。 贪: 告诉我什么事让我该说什么。 束: 告诉我为什么汤姆回家了。 ← 更通顺,但更远束搜索不一定每句都更好。它优化的目标是「整句概率最高」, 不是「和参考译文最像」。
这解释了一个常见困惑
为什么人看起来更通顺的句子,BLEU 反而更低?
因为 BLEU 比的是和参考译文的字面重叠, 不是「通顺程度」。
「告诉我为什么汤姆回家了」中文更自然, 但和「告诉汤姆我需要借他的车」一个字都对不上。
这就是 BLEU 的局限,下一课专门讲。
还有其他采法
方法 | 怎么做 | 什么时候用 |
|---|---|---|
贪心 | 每步取最大 | 要快 |
束搜索 | 保留 k 条 | 翻译的标准做法 |
温度采样 |
| 要多样性(写诗、对话) |
top-k 采样 | 只在前 k 个里随机抽 | 同上,但更稳 |
top-p(核采样) | 累积概率到 p 为止 | 现在大模型最常用 |
翻译不用采样——要的是最可能的那句,不是多样的那几句。 GPT 生成文本才用采样。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
贪心 BLEU | 7.23 | 2.4 秒 / 200 句 |
束搜索 BLEU | 10.45 | 27.6 秒,+45% |
代价 | 11.5× | k=5 时每步跑 5 次 |
下一课
BLEU 这个数到底怎么算的?为什么 7.23 和 10.45 都这么低?
下一课专门讲评估——包括它几个很严重的问题。