什么是 seq2seq
这一课在哪
上一课把问题问清楚了:要输出一整句话, 长度不定,而且要一个一个生成。
这一课给答案。这一章后面所有内容,都是给这个答案打补丁。
先看它属于哪一类任务
第 33.1 课列过序列任务的四种形态,当时只做了第一种:
形态 | 输入 | 输出 | 例子 |
|---|---|---|---|
多对一 | 一整句 | 一个标签 | 情感分析(第 33 章做过) |
一对多 | 一个东西 | 一整句 | 看图说话 |
多对多 | 一整句 | 一整句 | 翻译、摘要、对话 |
同长多对多 | n 个元素 | n 个标签 | 词性标注 |
翻译是「多对多」。而且是最难的那种多对多—— 前后长度不一样。
注意最后一行和第三行的区别
词性标注也是多对多,但它进几个出几个,一一对应。
翻译不是:「我不想去」4 个字进,「I don't want to go」6 个词出。
「进几个出几个」那种,一个位置一个位置算就行; 长度不定的这种,必须整体考虑。
核心思路:拆成两件事
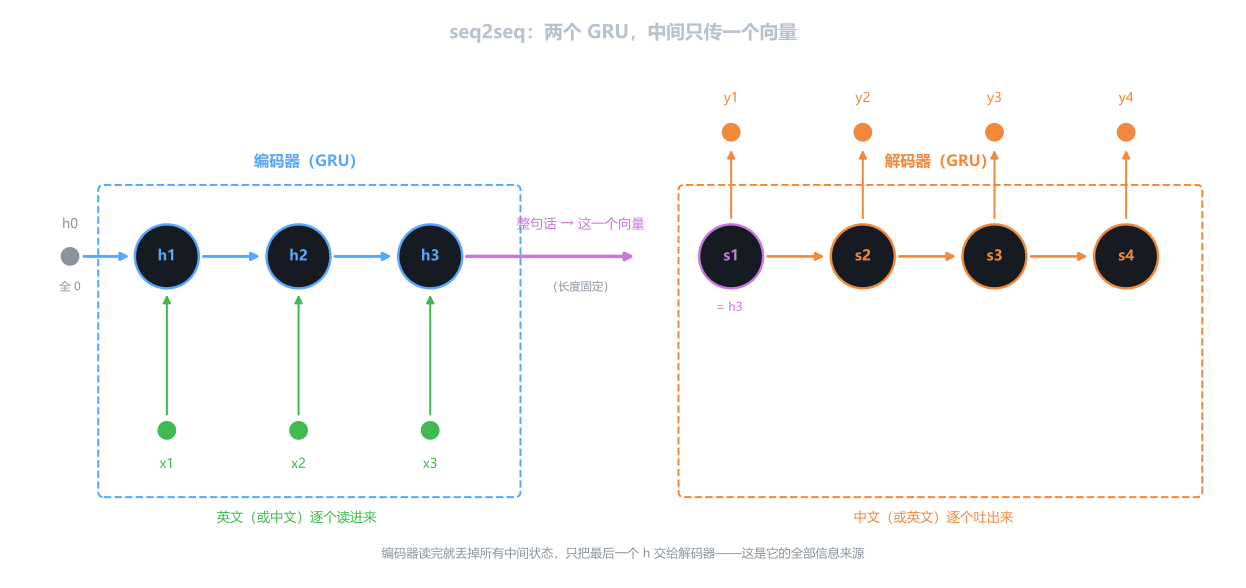
既然「读一整句」和「写一整句」是两件不同的事,那就用两个网络分别做。
角色 | 干什么 | 输出 |
|---|---|---|
编码器(encoder) | 读完整句,把它压成一个向量 | 一个固定长度的向量 |
解码器(decoder) | 拿着这个向量,一个词一个词地写 | 一整句话 |
这个结构就叫 seq2seq(sequence to sequence)。
编码器:怎么读
编码器就是一个普通的 GRU,和第 34 章那个一样。
import torch import torch.nn as nn encoder = nn.GRU(input_size=128, hidden_size=64, batch_first=True) # 一句英文,8 个词,每词 128 维 x = torch.randn(1, 8, 128) out, h_n = encoder(x) print(out.shape) # torch.Size([1, 8, 64]) 每一步的输出 print(h_n.shape) # torch.Size([1, 1, 64]) 最后一个 h关键决定:编码器只交出 h_n,out 全部丢掉。
张量 | 形状 | 命运 |
|---|---|---|
|
| 丢掉 |
|
| 交给解码器 |
这就是整个架构最关键、也最受质疑的一点
8 个词的信息,全部压进 64 个数。
out 里明明存着每一步看到什么,但 seq2seq 的原始设计 把它们全扔了。
为什么要扔?因为解码器不知道该跟哪一步对齐—— 中文 4 个字,英文 6 个词,对不上。
这个决定就是「瓶颈」,第 36 章的注意力就是来拆它的。
解码器:怎么写
解码器也是一个 GRU,但用法完全不同——它是一步一步调用的。
decoder_cell = nn.GRUCell(input_size=128, hidden_size=64) s = h_n.squeeze(0) # (1, 64) 拿编码器的 h 当初值 word = torch.randn(1, 128) # (1, 128) 这一步的输入 s = decoder_cell(word, s) # 走一步,得到新的 s print(s.shape) # torch.Size([1, 64])注意用的是 GRUCell 不是 GRU。
模块 | 一次吃多少 | 适合 |
|---|---|---|
| 整个序列 | 编码器(一次读完) |
| 一个时间步 | 解码器(要手控循环) |
为什么解码器必须用 Cell
nn.GRU 一次吞整个序列,中间不给插手的机会。
但生成第 2 个词时,第 1 个词才刚算出来, 根本还没有「整个序列」可喂。
GRUCell 一次只走一步, 你可以在两步之间做任何事——包括把上一步的输出接进来。
解码器每步做什么
一步里有三件事,顺序不能错:
① 用 s 算出这个词是哪个 → logits → softmax → 词 ② 把 s 传给下一步 ③ 把刚算出的词,当成下一步的输入class Decoder(nn.Module): def __init__(self, vocab_size, embed_dim=128, hidden=64): super().__init__() self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=0) self.cell = nn.GRUCell(embed_dim, hidden) self.fc = nn.Linear(hidden, vocab_size) def step(self, word_ids, s): embedded = self.embedding(word_ids) # (B, 128) s = self.cell(embedded, s) # (B, 64) logits = self.fc(s) # (B, vocab) return logits, sstep 一次只走一步,返回这个词的分数和新的状态。
两个网络怎么接起来
接的地方只有一处:编码器的 h_n 当解码器的初始状态。
class Seq2Seq(nn.Module): def __init__(self, src_vocab, tgt_vocab, embed_dim=128, hidden=64): super().__init__() self.encoder = Encoder(src_vocab, embed_dim, hidden) self.decoder = Decoder(tgt_vocab, embed_dim, hidden) def forward(self, src, tgt): # ① 编码器读完,只取最后的 h _, h_n = self.encoder(src) s = h_n.squeeze(0) # (B, 64) # ② 解码器一步步生成 outputs = [] word = tgt[:, 0] # 第一个输入是 <bos> for t in range(1, tgt.size(1)): logits, s = self.decoder.step(word, s) outputs.append(logits) word = tgt[:, t] # 训练时喂正确答案 return torch.stack(outputs, dim=1)注意 word = tgt[:, t] 这一行
这一行是训练时的写法:喂的是标准答案,不是自己刚猜的。
这叫 teacher forcing,下一课专门讲它为什么这么做、 有什么代价。
如果把这一行改成 word = logits.argmax(1), 就变成了推理时的写法。
形状走一遍
假设:源词表 8000,目标词表 6000,embed 128,hidden 64,batch 4。
位置 | 形状 | 说明 |
|---|---|---|
编码器输入 |
| 4 句,每句 10 个英文词 |
编码器 |
| 丢掉 |
编码器 |
| 压成 64 个数 |
解码器初态 |
| squeeze 掉第一维 |
每步 |
| 目标词表上的分数 |
全部输出 |
| 12 步 |
为什么这个设计能work
回头看,它把第 33.1 课那三个问题都解决了:
问题 | seq2seq 怎么答 |
|---|---|
长度不定 | 解码器一直生成,直到吐出 |
不能一次算完 |
|
对齐 | 不对齐——这是原始设计的选择,也是它的弱点 |
第三行的「不对齐」值得多想一秒
「我不想去」和「I don't want to go」,人是能对上「不 ↔ don't」的。
seq2seq 完全没有利用这个信息—— 它把整句压成一个向量,解码器从零开始写。
所以它对长句特别容易漏掉或重复。 第 36 章的注意力会让解码器「回头看」编码器的每一步, 这个结构就补上了。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
编码器交出 | 1 个向量 |
|
这个向量长度 | 64(hidden) | 整句唯一的出口 |
解码器每步 | 1 个词 | 用 |
下一课
结构讲完了。但有一个问题没解决: 训练时解码器的输入从哪来?
用自己刚猜的?还是用标准答案?下一课讲这件事, 以及它带来的一个不小的麻烦。