残差块:一个可以背下来的结构
这一课在哪
前两课把数学讲透了。这一课只做一件事: 把残差写成一个块(block)。
为什么要强调「块」?因为残差从来不只是一句 y = F(x) + x, 它是一个可以整体替换、整体复用的单元。
只记公式 | 记成块 |
|---|---|
|
|
不知道 F 里放什么 | F 可以是任何东西,块的外壳不变 |
换个网络就写不出来 | Transformer 里也长这样 |
最小的残差块:三行
先看最纯粹的形态,把细节都拿掉:
class ResidualBlock(nn.Module): def forward(self, x): return x + self.subnet(x)就这三行。整个残差连接的全部结构都在这里。
请把这三行记住
self.subnet(x) 是「某个子网络」, x 是「原样搬过来的输入」。
子网络学什么不重要,外壳永远是「输入 + 子网络(输入)」。
这个外壳在第 38 章 Transformer 里一模一样: x + Attention(x)、x + FFN(x)。
完整的残差块
真实网络里 subnet 是两层 3×3 卷积。补上就是:
class Residual(nn.Module): def __init__(self, in_channels, out_channels, stride=1): super().__init__() self.conv1 = nn.Conv2d( in_channels=in_channels, out_channels=out_channels, kernel_size=3, stride=stride, padding=1, bias=False, ) self.bn1 = nn.BatchNorm2d(out_channels) self.conv2 = nn.Conv2d( in_channels=out_channels, out_channels=out_channels, kernel_size=3, padding=1, bias=False, ) self.bn2 = nn.BatchNorm2d(out_channels) self.shortcut = self._make_shortcut(in_channels, out_channels, stride) def _make_shortcut(self, in_channels, out_channels, stride): if stride == 1 and in_channels == out_channels: return nn.Sequential() # 形状一样,什么都不用做 return nn.Sequential( nn.Conv2d( in_channels=in_channels, out_channels=out_channels, kernel_size=1, stride=stride, bias=False, ), nn.BatchNorm2d(out_channels), ) def forward(self, x): out = torch.relu(self.bn1(self.conv1(x))) out = self.bn2(self.conv2(out)) out = out + self.shortcut(x) return torch.relu(out)仔细看 forward,它和那个三行的块只差一件事:
三行版 | 完整版 | |
|---|---|---|
子网络 |
|
|
搬过来的输入 |
|
|
相加 |
|
|
激活 | 无 |
|
shortcut 为什么是个「层」
形状不变时它是空的 nn.Sequential(),调用就是在返回 x 本身。
形状变化时才变成 1×1 卷积。
这样写的好处是 forward 里不用分支判断——不管哪种情况都调 self.shortcut(x)。
为什么要可以「搬过来」
形状必须完全一样才能相加。三种情况:
通道 | 尺寸 | 捷径怎么做 | 参数 |
|---|---|---|---|
不变 | 不变 | 直接用 x | 0 |
变化 | 不变 | 1×1 卷积改通道 | C_in × C_out + 2·C_out |
变化 | 减半 | 1×1 卷积,stride=2 | C_in × C_out + 2·C_out |
算一下真实的数:
def count(module): return sum(p.numel() for p in module.parameters()) print(count(Residual(32, 32))) # 18,560 print(count(Residual(32, 64, 2))) # 57,728 print(Residual(32, 64, 2).shortcut)18560 57728 Sequential( (0): Conv2d(32, 64, kernel_size=(1, 1), stride=(2, 2), bias=False) (1): BatchNorm2d(64, eps=1e-05, momentum=0.1) )形状不变时残差是白拿的
Residual(32, 32) 是 18,560 个参数。
同样两层 3×3 卷积 + BN 的普通块,也是 18,560。
一个参数不多,效果差一截。
ReLU 为什么在加法之后
两种写法看起来差不多,但结果差很远:
# ✓ 正确:先加,再激活 out = self.bn2(self.conv2(out)) out = out + self.shortcut(x) return torch.relu(out) # ✗ 错误:先激活,再相加 out = self.bn2(self.conv2(out)) out = torch.relu(out) + self.shortcut(x) return out错在:加上 x 之后结果可能是负数, 而它要为下一层提供「原始信息 + 修正」。如果加完不激活, 负值能传下去;如果先激活,F(x) 里所有负数都变成 0 了。
原论文的说法是:恒等映射必须在「加法」这条路上保持干净—— 从 x 到输出的路径上不能有任何会改变符号的操作。
这条规则的来源
ResNet 原论文的图和公式都写成 y = ReLU(F(x) + x),激活在外面。
后来有论文(Identity Mappings in Deep Residual Networks)进一步建议 把激活也移到块内部,让捷径完全「干净」。
但对绝大多数场景,「加完再 ReLU」就够了。
这个块的形状
block = Residual(32, 32) x = torch.randn(1, 32, 96, 96) print(block(x).shape) # torch.Size([1, 32, 96, 96]) 进去出来一样 block2 = Residual(32, 64, stride=2) print(block2(x).shape) # torch.Size([1, 64, 48, 48]) 通道翻倍,尺寸减半块 | 输入 | 输出 | 参数 |
|---|---|---|---|
| 32@96×96 | 32@96×96 | 18,560 |
| 32@96×96 | 64@48×48 | 57,728 |
把块背下来
以后再看到任何残差结构,先在脑子里还原这个骨架:
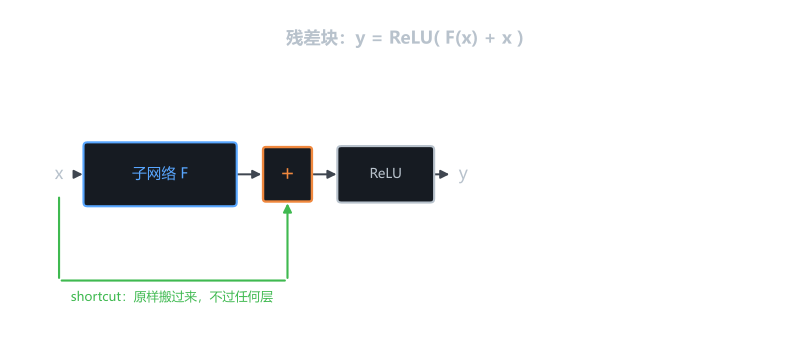
变换的只有三处:
可以变 | 例子 |
|---|---|
子网络是什么 | 两层卷积(ResNet)/ 注意力(Transformer)/ 全连接(FFN) |
shortcut 怎么搬 | 直接搬 / 1×1 卷积 / LayerNorm |
激活放哪 | 加法之后 / 块内部(pre-activation) |
下一课
块会写了。下一课开始搭整个网络——一个块、两个块、一段、四段, 每一段都保证高速公路不断。