一块一块搭起来
这一课在哪
上一课把残差块写出来了,它只有三行: return x + self.subnet(x)。
这一课一块一块往上堆,从 3 个通道堆到 256 个。 每一块都单独讲,不省略。
为什么必须一块一块讲
ResNet 不是「一个网络」,是一套拼装规则。
学会拼装,你看到 ResNet-34、ResNet-50、ResNet-101 都认得出来—— 它们只是同一个模板换了层数。
记住模板,比记住某一个网络有用得多。
整体蓝图
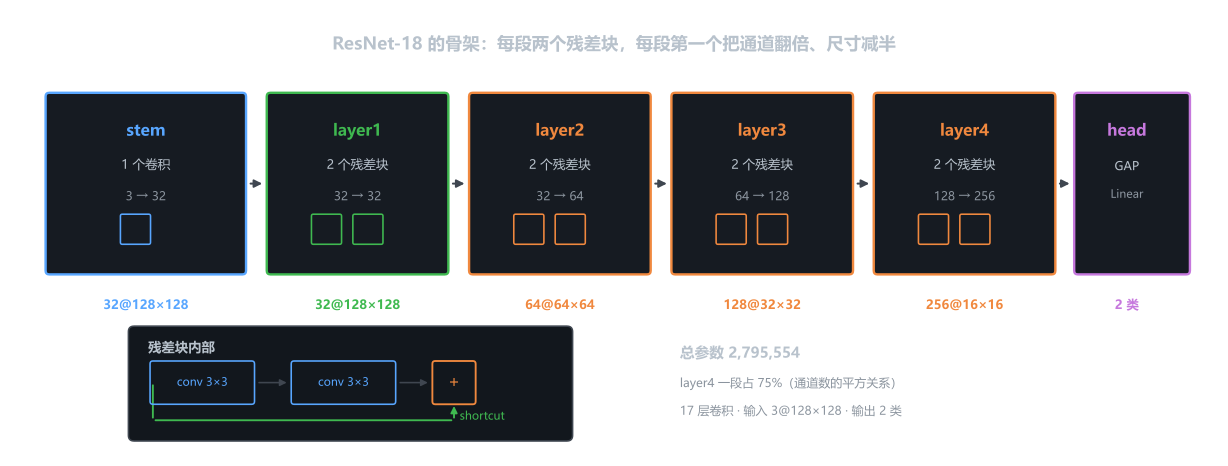
整个网络分五段。先看名字和职责,后面逐段展开:
段 | 干什么 | 块数 | 形状变化 |
|---|---|---|---|
| 把 3 通道变成 32 通道 | 1 个卷积 | 3@128×128 → 32@128×128 |
| 保持 32 通道,尺寸不变 | 2 个残差块 | 32@128×128 → 32@128×128 |
| 翻倍到 64 通道,尺寸减半 | 2 个残差块 | 32@128×128 → 64@64×64 |
| 翻倍到 128 通道,尺寸减半 | 2 个残差块 | 64@64×64 → 128@32×32 |
| 翻倍到 256 通道,尺寸减半 | 2 个残差块 | 128@32×32 → 256@16×16 |
| 压成 1×1,出 2 类 | 池化 + 全连接 | 256@16×16 → 2 |
注意这个节奏
layer1 什么都不改,因为刚把 3 通道变成 32,先让它在 32 通道上消化一下。
layer2、3、4 各做一次「通道 ×2,尺寸 ÷2」—— 用 stride=2 的 1×1 卷积在捷径上同步缩小。
stem:入口
stem 是「茎」的意思——网络的主干从这里长出来。 它不是残差块,就是一个普通卷积:
self.stem = nn.Sequential( nn.Conv2d( in_channels=3, out_channels=32, kernel_size=3, stride=1, padding=1, bias=False, ), nn.BatchNorm2d(32), nn.ReLU(inplace=True), )项 | 值 |
|---|---|
输入 | 3@128×128 |
输出 | 32@128×128 |
参数 | 3×32×3×3 + 32×2 = 928 |
padding=1 配 kernel_size=3、stride=1, 所以尺寸不变,只换通道。
为什么 stem 不是残差块
残差需要 x 和 F(x) 形状一致。
stem 要把 3 通道变成 32 通道,输入输出形状差太远, 加捷径反而要多一个 1×1 卷积,没必要。
所有 ResNet 的 stem 都是普通的几个卷积层。
layer1:两个块,什么都不改
self.layer1 = nn.Sequential( Residual(32, 32), Residual(32, 32), )第 1 个块:Residual(32, 32)
输入 32 通道、输出 32 通道、步长 1。所以:
Residual(32, 32) conv1: Conv2d(32, 32, 3, stride=1, padding=1) 9,216 参数 bn1: BatchNorm2d(32) 64 conv2: Conv2d(32, 32, 3, stride=1, padding=1) 9,216 bn2: BatchNorm2d(32) 64 shortcut: 空的(形状一样) 0 ───────────────────────────────────────────────────── 合计 18,560流 | 形状 |
|---|---|
进 | 32@128×128 |
conv1 → bn1 → relu | 32@128×128 |
conv2 → bn2 | 32@128×128 |
+ shortcut(x) | 32@128×128 |
relu | 32@128×128 |
出 | 32@128×128 |
第 2 个块:Residual(32, 32)
和第 1 个完全一样,参数也是 18,560。输入输出都是 32@128×128。
layer1 合计 = 18,560 × 2 = 37,120。
为什么要两个一样的块
一个块只能做一次「卷积 + 相加」。两个块就是连续两次修正。
ResNet-18 的每一段都是 2 个块,ResNet-34 是 3~6 个。 块数是可以调的旋钮,结构不变。
layer2:第一次缩小
self.layer2 = nn.Sequential( Residual(32, 64, stride=2), Residual(64, 64), )注意这两个块不一样——第一个改形状,第二个不改。
第 1 个块:Residual(32, 64, stride=2)
通道 32→64,尺寸 128→64。捷径必须同步做同样的事:
Residual(32, 64, stride=2) conv1: Conv2d(32, 64, 3, stride=2, padding=1) 18,432 bn1: BatchNorm2d(64) 128 conv2: Conv2d(64, 64, 3, stride=1, padding=1) 36,864 bn2: BatchNorm2d(64) 128 shortcut: Conv2d(32, 64, 1, stride=2) 2,048 BatchNorm2d(64) 128 ───────────────────────────────────────────────────── 合计 57,728流 | 形状 |
|---|---|
进 x | 32@128×128 |
conv1(stride=2) | 64@64×64 |
conv2 | 64@64×64 |
shortcut(x)(1×1 stride=2) | 64@64×64 |
相加 + relu | 64@64×64 |
第 2 个块:Residual(64, 64)
Residual(64, 64) conv1: Conv2d(64, 64, 3, stride=1, padding=1) 36,864 bn1: BatchNorm2d(64) 128 conv2: Conv2d(64, 64, 3, stride=1, padding=1) 36,864 bn2: BatchNorm2d(64) 128 shortcut: 空的 0 ───────────────────────────────────────────────────── 合计 73,984进 64@64×64,出 64@64×64。
layer2 合计 = 57,728 + 73,984 = 131,712。
这一段最值得记住
每段的第一个块负责改形状,第二个块负责原地加工。
layer2、layer3、layer4 全是这个模式: Residual(入, 出, stride=2) + Residual(出, 出)。
记住这一条,ResNet 的任何变体你都能照着念出来。
layer3:再翻倍
self.layer3 = nn.Sequential( Residual(64, 128, stride=2), Residual(128, 128), )第 1 个块:Residual(64, 128, stride=2)
Residual(64, 128, stride=2) conv1: Conv2d(64, 128, 3, stride=2, padding=1) 73,728 bn1: BatchNorm2d(128) 256 conv2: Conv2d(128, 128, 3, stride=1, padding=1) 147,456 bn2: BatchNorm2d(128) 256 shortcut: Conv2d(64, 128, 1, stride=2) 8,192 BatchNorm2d(128) 256 ───────────────────────────────────────────────────── 合计 230,144进 64@64×64,出 128@32×32。
第 2 个块:Residual(128, 128)
Residual(128, 128) conv1: Conv2d(128, 128, 3, stride=1, padding=1) 147,456 bn1: BatchNorm2d(128) 256 conv2: Conv2d(128, 128, 3, stride=1, padding=1) 147,456 bn2: BatchNorm2d(128) 256 shortcut: 空的 0 ───────────────────────────────────────────────────── 合计 295,424进 128@32×32,出 128@32×32。
layer3 合计 = 230,144 + 295,424 = 525,568。
layer4:最后一次翻倍
self.layer4 = nn.Sequential( Residual(128, 256, stride=2), Residual(256, 256), )第 1 个块:Residual(128, 256, stride=2)
Residual(128, 256, stride=2) conv1: Conv2d(128, 256, 3, stride=2, padding=1) 294,912 bn1: BatchNorm2d(256) 512 conv2: Conv2d(256, 256, 3, stride=1, padding=1) 589,824 bn2: BatchNorm2d(256) 512 shortcut: Conv2d(128, 256, 1, stride=2) 32,768 BatchNorm2d(256) 512 ───────────────────────────────────────────────────── 合计 919,040进 128@32×32,出 256@16×16。
第 2 个块:Residual(256, 256)
Residual(256, 256) conv1: Conv2d(256, 256, 3, stride=1, padding=1) 589,824 bn1: BatchNorm2d(256) 512 conv2: Conv2d(256, 256, 3, stride=1, padding=1) 589,824 bn2: BatchNorm2d(256) 512 shortcut: 空的 0 ───────────────────────────────────────────────────── 合计 1,180,672进 256@16×16,出 256@16×16。
layer4 合计 = 919,040 + 1,180,672 = 2,099,712。
head:出口
和 NiN 学到的一样——全局平均池化 + 一层全连接:
self.head = nn.Sequential( nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(), nn.Linear(in_features=256, out_features=2), )项 | 值 |
|---|---|
输入 | 256@16×16 |
池化后 | 256@1×1 |
拉平 | 256 |
输出 | 2 |
参数 | 256×2 + 2 = 514 |
head 只有 514 个参数
对比 VGG:全连接三层 1.24 亿。
ResNet 用全局平均池化,把这一块压到了 514 个。
这是 NiN 那一课留下的遗产。
拼起来
class ResNet(nn.Module): def __init__(self, num_classes=2): super().__init__() self.stem = nn.Sequential( nn.Conv2d(3, 32, 3, 1, 1, bias=False), nn.BatchNorm2d(32), nn.ReLU(inplace=True), ) self.layer1 = nn.Sequential(Residual(32, 32), Residual(32, 32)) self.layer2 = nn.Sequential(Residual(32, 64, 2), Residual(64, 64)) self.layer3 = nn.Sequential(Residual(64, 128, 2), Residual(128, 128)) self.layer4 = nn.Sequential(Residual(128, 256, 2), Residual(256, 256)) self.head = nn.Sequential( nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(), nn.Linear(256, num_classes), ) def forward(self, x): x = self.stem(x) x = self.layer1(x) x = self.layer2(x) x = self.layer3(x) x = self.layer4(x) logits = self.head(x) return logits逐段验证形状
model = ResNet() x = torch.randn(1, 3, 128, 128) for name in ["stem", "layer1", "layer2", "layer3", "layer4"]: x = getattr(model, name)(x) print(f"{name:<8} {tuple(x.shape)}") print(f"{'head':<8} {tuple(model.head(x).shape)}")stem (1, 32, 128, 128) layer1 (1, 32, 128, 128) layer2 (1, 64, 64, 64) layer3 (1, 128, 32, 32) layer4 (1, 256, 16, 16) head (1, 2)参数汇总
段 | 块 | 参数 | 累计 |
|---|---|---|---|
stem | conv 3→32 | 928 | 928 |
layer1 | Residual(32,32) | 18,560 | |
Residual(32,32) | 18,560 | 37,120 | |
layer2 | Residual(32,64,2) | 57,728 | |
Residual(64,64) | 73,984 | 131,712 | |
layer3 | Residual(64,128,2) | 230,144 | |
Residual(128,128) | 295,424 | 525,568 | |
layer4 | Residual(128,256,2) | 919,040 | |
Residual(256,256) | 1,180,672 | 2,099,712 | |
head | GAP + Linear | 514 | 514 |
合计 | 2,795,554 |
layer4 一段占了 75%
2,099,712 ÷ 2,795,554 = 75.1%
因为它的通道最多(256),而卷积参数量是通道数的平方。
256×256×9 = 589,824,光一个卷积就比整个 layer1 大 16 倍。
这个结构可以背
位置 | 通道 | 块数 | 第一个块的 stride |
|---|---|---|---|
stem | 3 → 32 | — | 1 |
layer1 | 32 → 32 | 2 | 1(不改形状) |
layer2 | 32 → 64 | 2 | 2 |
layer3 | 64 → 128 | 2 | 2 |
layer4 | 128 → 256 | 2 | 2 |
head | 256 → 类别数 | — | — |
「每段两个块,第一个块 stride=2」—— 这一行话就是 ResNet-18 的全部结构。
把块数改成 [3,4,6,3] 就是 ResNet-34。改通道数是 ResNet-50。
下一课
结构搭完了。下一课把它拿去训猫狗分类—— 这一课是零件,下一课是成品。