完整 ResNet 与训练
这一课在哪
上一课把五个段一块一块搭完了,零件齐了。 这一课只是把它们连起来跑一遍——没有新结构。
验收项 | 标准 |
|---|---|
参数量 | 2,795,554 |
测试准确率 | > 95% |
训练耗时 | 20 轮 × 23 秒 |
数据:猫狗二分类
1000 张图,500 猫 + 500 狗,128×128,按 70/15/15 分:
from torchvision import transforms train_transform = transforms.Compose([ transforms.Resize((128, 128)), transforms.RandomHorizontalFlip(), transforms.RandomCrop(128, padding=8), transforms.ToTensor(), transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)), ]) eval_transform = transforms.Compose([ transforms.Resize((128, 128)), transforms.ToTensor(), transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)), ])集合 | 张数 |
|---|---|
训练 | 700 |
验证 | 150 |
测试 | 150 |
为什么用 RandomCrop 而不是 Resize 到更大
Resize(128) 之后 RandomCrop(128, padding=8)—— 先缩到 128,再补 8 圈然后随机裁回 128。
这样每次看到的都是略微不同的一小块, 相当于把 700 张训练图变成「看起来更多」。
7 万参数级的网络配 700 张图,不做增强会立刻过拟合。
把上一课的五段连起来
上一课的每个零件原样搬过来,只是拼成一个类:
class ResNet(nn.Module): def __init__(self, num_classes=2): super().__init__() self.stem = nn.Sequential( nn.Conv2d(3, 32, 3, 1, 1, bias=False), nn.BatchNorm2d(32), nn.ReLU(inplace=True), ) self.layer1 = nn.Sequential(Residual(32, 32), Residual(32, 32)) self.layer2 = nn.Sequential(Residual(32, 64, 2), Residual(64, 64)) self.layer3 = nn.Sequential(Residual(64, 128, 2), Residual(128, 128)) self.layer4 = nn.Sequential(Residual(128, 256, 2), Residual(256, 256)) self.head = nn.Sequential( nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(), nn.Linear(256, num_classes), ) def forward(self, x): x = self.stem(x) x = self.layer1(x) x = self.layer2(x) x = self.layer3(x) x = self.layer4(x) logits = self.head(x) return logits数参数、看形状:
model = ResNet(num_classes=2) print(sum(p.numel() for p in model.parameters())) # 2,795,554 x = torch.randn(1, 3, 128, 128) for name in ["stem", "layer1", "layer2", "layer3", "layer4"]: x = getattr(model, name)(x) print(f"{name:<8} {tuple(x.shape)}") print(f"{'head':<8} {tuple(model.head(x).shape)}")2795554 stem (1, 32, 128, 128) layer1 (1, 32, 128, 128) layer2 (1, 64, 64, 64) layer3 (1, 128, 32, 32) layer4 (1, 256, 16, 16) head (1, 2)训练
from torch.utils.data import DataLoader train_loader = DataLoader(train_set, batch_size=32, shuffle=True) val_loader = DataLoader(val_set, batch_size=64) test_loader = DataLoader(test_set, batch_size=64) device = "cuda" if torch.cuda.is_available() else "cpu" model = ResNet(num_classes=2).to(device) loss_fn = nn.CrossEntropyLoss() optimizer = torch.optim.Adam(model.parameters(), lr=1e-3) for epoch in range(1, 21): model.train() train_loss, seen, train_correct = 0.0, 0, 0 for images, labels in train_loader: images = images.to(device) labels = labels.to(device) logits = model(images) loss = loss_fn(logits, labels) optimizer.zero_grad() loss.backward() optimizer.step() train_loss += loss.item() * labels.size(0) seen += labels.size(0) train_correct += (logits.argmax(dim=1) == labels).sum().item() model.eval() val_correct, val_seen = 0, 0 with torch.no_grad(): for images, labels in val_loader: images = images.to(device) labels = labels.to(device) val_correct += (model(images).argmax(dim=1) == labels).sum().item() val_seen += labels.size(0) print( f"{epoch} loss {train_loss/seen:.4f} " f"train {100*train_correct/seen:.2f}% " f"val {100*val_correct/val_seen:.2f}%" )真实跑出来(RTX 5060,每轮 23 秒):
1 loss 0.6085 train 73.71% val 46.67% 2 loss 0.3647 train 84.86% val 76.67% 4 loss 0.1681 train 94.29% val 84.67% 6 loss 0.1133 train 96.00% val 86.67% 8 loss 0.1296 train 94.86% val 78.00% 10 loss 0.0809 train 97.29% val 66.67% 12 loss 0.0483 train 98.29% val 77.33% 14 loss 0.0810 train 96.57% val 90.00% 16 loss 0.0625 train 97.86% val 53.33% 18 loss 0.0612 train 97.71% val 92.00% 20 loss 0.0216 train 99.43% val 96.67% 测试集 98.00%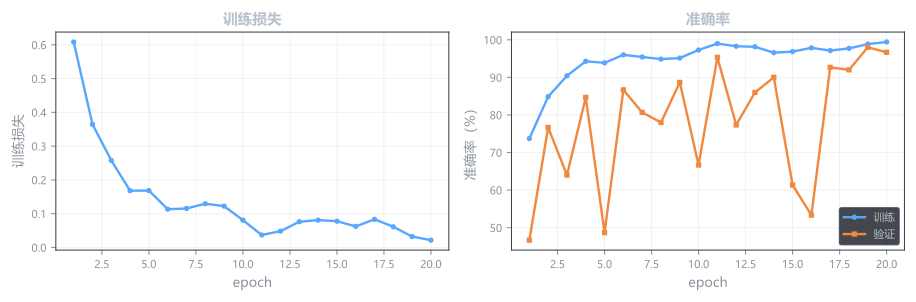
曲线里最该注意的
验证准确率这一列非常吵:96.67% → 53.33% → 92.00%。
轮 | 训练 | 验证 | 怎么回事 |
|---|---|---|---|
10 | 97.29% | 66.67% | 训练已经很好了,验证崩了 |
16 | 97.86% | 53.33% | 几乎等于瞎猜 |
20 | 99.43% | 96.67% | 又好了 |
验证集只有 150 张
错 1 张就是 0.67%,错 70 张才掉到 53%。
53.33% 意味着 150 张里错了 70 张——这不是「模型突然变笨」, 而是测试时的 BatchNorm 统计量在抖。
训练时 BN 用当前 batch 的均值方差; 推理时用滑动平均。700 张图、22 个 batch, 滑动平均还没收敛,所以推理结果会突然抖动。
小验证集的正确读法
不要看某一轮的数字,看趋势,或者用「最近 5 轮平均」。
真实项目里验证集至少几百张,否则选不出模型。
测试集与混淆矩阵
model.eval() correct, total = 0, 0 confusion = torch.zeros(2, 2, dtype=torch.int) with torch.no_grad(): for images, labels in test_loader: images = images.to(device) labels = labels.to(device) preds = model(images).argmax(dim=1) correct += (preds == labels).sum().item() total += labels.size(0) for true_label, pred_label in zip(labels.cpu(), preds.cpu()): confusion[int(true_label), int(pred_label)] += 1 print(f"测试集 {100 * correct / total:.2f}%") print(confusion)测试集 98.00% tensor([[66, 1], [ 2, 81]])真实 \ 预测 | 猫 | 狗 | 合计 | 召回 |
|---|---|---|---|---|
猫 | 66 | 1 | 67 | 98.5% |
狗 | 2 | 81 | 83 | 97.6% |
合计 | 68 | 82 | 150 |
150 张里只错了 3 张。1 只猫被认成狗,2 只狗被认成猫。
和前面几个网络对比
网络 | 参数 | 数据 | 测试准确率 |
|---|---|---|---|
8 层普通(无 BN) | 65,698 | 猫狗 | 69.33% |
20 层普通(无 BN) | 176,674 | 猫狗 | 44.67% |
32 层普通(无 BN) | 287,650 | 猫狗 | 44.67% |
ResNet(17 层卷积) | 2,795,554 | 猫狗 | 98.00% |
44.67% → 98.00%
20 层和 32 层的普通网络根本学不动, 测试准确率 44.67%,比瞎猜还低(瞎猜是 50%)。
ResNet 用 2.8M 参数、20 轮,做到 98%。
这不是「参数多所以强」——普通网络参数更少,反而学不动。 差别只在那个 + x。
这一课带走什么
# | 结论 |
|---|---|
1 | 五段拼起来就是完整 ResNet,没有新东西 |
2 | 700 张图 + 2.8M 参数,必须做数据增强 |
3 | 小验证集上的数字会剧烈抖动,看趋势不看单点 |
4 | 同样的数据,普通深层网络学不动,ResNet 能到 98% |
下一课
结构、训练都走通了。下一课看 ResNet 的变体, 以及它为什么能活到今天——包括怎么进的 Transformer。