解码器的一层
这一课在哪
编码器拆完了。解码器大部分和它一样, 只有两处是新的。
同样地,六层是同一个结构复制六份,只理解一层就够。
完整结构
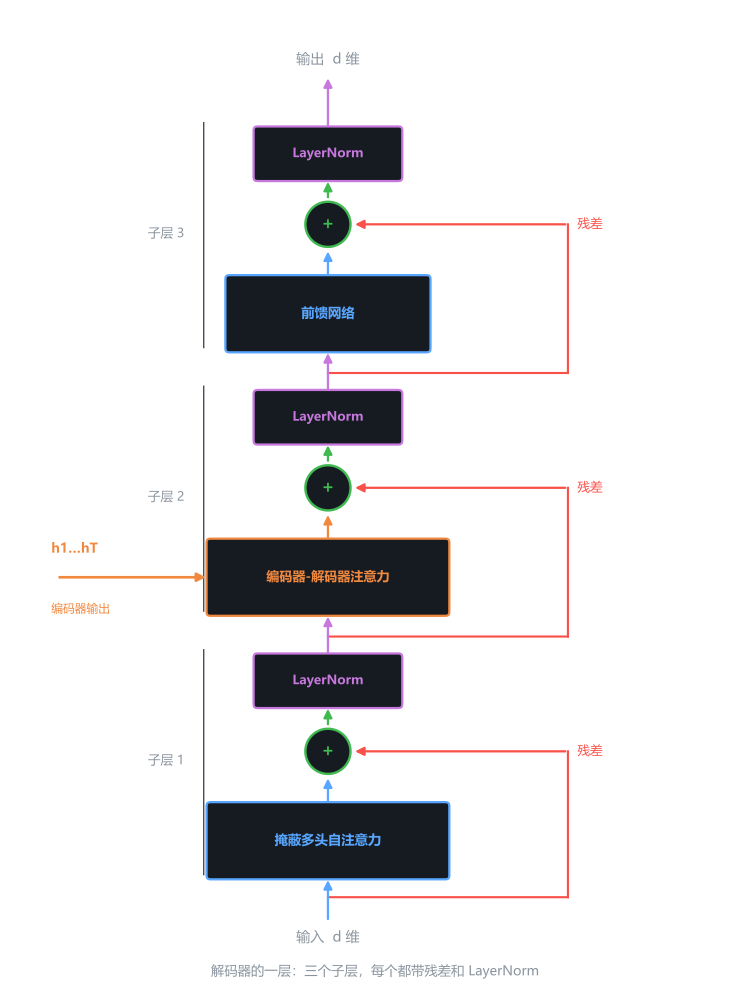
和编码器并排对比,一眼看出差别:
编码器一层 | 解码器一层 | |
|---|---|---|
子层 1 | 多头自注意力 | 掩蔽多头自注意力 |
子层 2 | — | 编码器-解码器注意力 |
子层 3 | 前馈网络 | 前馈网络 |
残差 + LayerNorm | 两处 | 三处 |
只有两处是新的
① 自注意力前面多了「掩蔽」两个字。
② 中间多了一个子层,用来接收编码器的输出。
前馈网络、残差、LayerNorm 都和编码器一模一样, 上一课讲过,这里不再重复。
子层 1:为什么必须掩蔽
问题出在训练方式上
训练时,整句标准答案都在手上。 解码器一口气把四个位置全算了:
位置 1 要预测「I」 位置 2 要预测「like」 位置 3 要预测「you」 位置 4 要预测「<eos>」但位置 1 算的时候,如果它能看见位置 2、3、4 的输入—— 而输入里就有 like you <eos>—— 那它直接把答案抄过来就行了。
这叫「偷看答案」
训练时表现完美,推理时第一个词就露馅——因为那时后面什么都没有。
所以必须强制:位置 i 只能看位置 0 到 i。
这就是「保留自回归属性」的意思——每一步都只看已经生成的。
掩码长什么样
一个下三角矩阵,1 表示「可以看」,0 表示「不许看」:
第 1 行只能看第 1 个,第 2 行能看前两个,依此类推。
实算一遍
假设算出来的分数是这样(随便取的数):
不加掩码,直接 softmax:
看第 1 行:0.6439 的权重给了位置 4—— 它在看第四个词,那是它要预测的答案。
加掩码:把 0 的位置填成 ,再过 softmax:
行 | 能看到 | 权重 |
|---|---|---|
第 1 行 | 只有位置 1 | 1.0000,别无选择 |
第 2 行 | 位置 1、2 | 0.7311 / 0.2689 |
第 3 行 | 位置 1、2、3 | 0.2595 / 0.7054 / 0.0351 |
第 4 行 | 全部 | 和不加掩码一样 |
注意最后一行
第 4 行加不加掩码结果完全一样——因为它本来就该看到全部。
掩码只砍掉右上角那一块,左下角本来就没被砍。
为什么填 而不是 0
因为要过 softmax。,填 0 是没效果的—— 权重照样会分过去。
要填一个足够小的负数,, softmax 之后才是真正的 0。
子层 2:编码器-解码器注意力
这个子层是解码器唯一接收外部信息的地方。
Q、K、V 各从哪来
角色 | 来自 | 形状 |
|---|---|---|
Q 查询 | 解码器上一个子层的输出 | |
K 键 | 编码器最后一层的输出 | |
V 值 | 同一个编码器输出 |
这就是第 36.9 课那个注意力
Q 一边、K 和 V 另一边——跨注意力。
区别只是:36.9 那里 Q 来自 RNN 的隐状态, 这里 Q 来自上一个子层的输出。
机制完全一样,用的就是第 36.5 课手算过的那个跨注意力。
两边的长度不一样,怎么办
源句 10 个词、目标句 6 个词,那 Q 是 6 行、K 是 10 行。
没问题——注意力本来就是「每个 Q 和所有 K 打分」, 两边长度不同是常态。
量 | 形状 | 说明 |
|---|---|---|
|
| 目标句 6 个位置 |
|
| 源句 10 个位置 |
|
| 每行一个目标位置,10 个源位置 |
softmax 后 |
| 每个目标位置对 10 个源词的权重 |
输出 |
| 回到目标句长度,能接残差 |
这一层要加 padding mask,不加 causal mask
编码器输出里可能有补出来的 padding,要屏蔽掉——这是 padding mask。
但不需要 causal mask:源句是完整已知的, 每个目标位置都可以看源句的全部,没有「未来」可言。
两种 mask,四个名字
这里最容易糊涂:代码里会看到两个不同的 mask 参数, 它们是两回事。
屏什么 | 用在哪 | 不同教材的叫法 |
|---|---|---|
补出来的词 | 所有注意力 |
|
未来的词 | 只有解码器自注意力 |
|
有一份教程的参数名把这个分工写得很清楚:
# 解码器自注意力:用 look_ahead,不许看未来 attn = self.mh[0](yz, yz, yz, yz_look_ahead_mask) # 编码器-解码器注意力:用 pad,只屏蔽补出来的 attn = self.mh[1](o1, xz, xz, xz_pad_mask)注意第一行的 yz, yz, yz——Q K V 全是自己, 所以叫「自」注意力。第二行是 o1, xz, xz—— Q 是自己的 o1,K V 是编码器的 xz。
子层 3 和外面的壳
两句话带过,上一课都讲过:
部件 | 这一课 |
|---|---|
前馈网络 | 和编码器完全相同:两个全连接层,放大 4 倍 → ReLU → 压回 |
残差 + LayerNorm | 同样套在每个子层外面,所以解码器一层是三组 |
整层串起来
class DecoderLayer(nn.Module): def __init__(self, d_model=512, n_heads=8, d_ff=2048): super().__init__() self.self_attn = MultiHeadAttention(d_model, n_heads) self.cross_attn = MultiHeadAttention(d_model, n_heads) self.ffn = PositionWiseFFN(d_model, d_ff) self.norm1 = nn.LayerNorm(d_model) self.norm2 = nn.LayerNorm(d_model) self.norm3 = nn.LayerNorm(d_model) def forward(self, y, enc_out, causal_mask, pad_mask): # 子层 1:掩蔽自注意力(Q K V 都是自己) y = self.norm1(y + self.self_attn(y, y, y, causal_mask)) # 子层 2:跨注意力(Q 是自己,K V 是编码器输出) y = self.norm2(y + self.cross_attn(y, enc_out, enc_out, pad_mask)) # 子层 3:前馈网络 y = self.norm3(y + self.ffn(y)) return y看第 2 个子层那一行:三个参数是 y, enc_out, enc_out—— Q 是 y,K 和 V 都是 enc_out。 这一行就是整个解码器最关键的地方。
参数比编码器多一点
部分 | 编码器一层 | 解码器一层 |
|---|---|---|
自注意力 | 1,050,624 | 1,050,624(掩蔽不增加参数) |
跨注意力 | — | 1,050,624 |
前馈网络 | 2,099,712 | 2,099,712 |
三个 LayerNorm | 2,048(两个) | 3,072(三个) |
合计 | 3,152,384 | 4,204,032 |
解码器一层多出约 33%,多出来的几乎全是那个跨注意力。
但「掩蔽」本身一个参数都不加——它只是在分数上加了个负无穷, 没有引入任何可学习的东西。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
子层数 | 3 | 比编码器多一个跨注意力 |
掩码填充值 | 不能填 0, 没用 | |
掩码带来的参数 | 0 | 纯计算,不学任何东西 |
下一课
层拆完了。下一课把 6 层编码器 + 6 层解码器拼成完整模型, 然后在同一个中英翻译任务上真训一遍。
最后和第 36 章那个带注意力的 seq2seq 对比—— BLEU 28.63 那个数。