位置编码
先算一遍,看看问题在哪
三个 token,每个 2 维。为了手算方便,取 :
于是 。算分数:
逐行 softmax:
加权求和:
现在把第 1 个和第 3 个换一下
交换用置换矩阵 表示:
重新算一遍,得到:
和第 1 步那个 对比一下:
这就是问题
,一模一样。
输入换了顺序,输出只是跟着换位置,数值一个没变。
换句话说:自注意力只能算出「谁和谁有关系」, 算不出「谁先谁后」。它看到的是一堆向量,不是一个序列。
那就把位置塞进输入里
既然问题是「输入里没有位置」,办法就很直接: 给每个位置配一个向量,塞进输入。
塞的方式有两种:
相加: x_i' = x_i + p_i 相乘: x_i' = x_i ⊙ p_i 或 x_i' = R_i · x_i先试最笨的那个。
试法一:one-hot
第 个位置就配一个「第 i 位是 1,其余全 0」的向量:
加到词向量上,确实能区分位置了。但有三个硬伤:
# | 问题 |
|---|---|
① | 维度得等于最大长度。 要处理 4096 个词,就得往词向量后面接 4096 维 |
② | 没有距离概念。 第 0 位和第 1 位互不相容,第 0 位和第 99 位也互不相容—— 远近完全体现不出来 |
③ | 大部分维度是 0。 加进去等于给词向量硬塞一长串 0,浪费而且打乱了原来的尺度 |
第 ② 条是致命的
模型最需要知道的是「这两个词隔多远」, 而不是「它们各自在第几号」。
one-hot 里任意两个位置完全平等, 距离信息一点都没有。
换个思路:让编号「连续变化」
想要距离有意义,就需要一个随位置连续变化的东西。
先看二进制怎么写 0 到 7:
0 000 1 001 2 010 3 011 4 100 5 101 6 110 7 111注意三列的翻转速度:最低位每格翻一次,中间位每两格翻一次,最高位每四格翻一次。
「哪些位在翻」本身就编码了位置。位置越大,翻到的位越高。
这就是正弦编码的来源
把「0/1 翻转」换成「正弦波振荡」,就有了连续版本: 不同维度用不同频率的正弦波。
低维振荡快(像秒针),高维振荡慢(像时针)。 一组不同速度的指针放在一起,每个位置都是一个独特组合。
试法二:正弦(原论文)
是位置, 是第几组。取 ,手算四行:
j=0: 频率 1 j=1: 频率 100 pos=0 [0.0000, 1.0000, 0.0000, 1.0000] pos=1 [0.8415, 0.5403, 0.0100, 1.0000] pos=2 [0.9093, -0.4161, 0.0200, 0.9998] pos=3 [0.1411, -0.9900, 0.0300, 0.9996]维度 | pos 0 → 3 | 像 |
|---|---|---|
第 0、1 维 | 0.0000 → 0.8415 → 0.9093 → 0.1411 | 秒针 |
第 2、3 维 | 0.0000 → 0.0100 → 0.0200 → 0.0300 | 时针 |
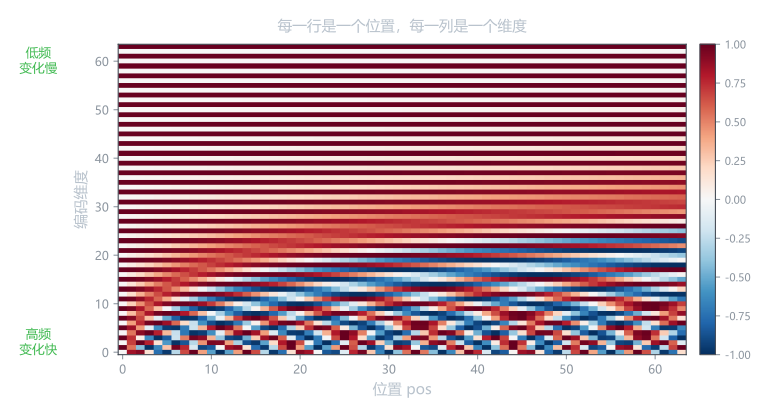
正弦编码能用了,但它还是加法——加进词向量里。 它有两个毛病:
# | 毛病 |
|---|---|
① | 只给绝对位置。 注意力真正关心的是「隔多远」,模型得自己从绝对位置里推相对位置 |
② | 加进去会改语义。 位置信息和词义揉在一起,模型分不清哪些是「词的意思」、哪些是「位置」 |
现在的好办法:RoPE
主流大模型(Llama、Qwen、GPT-NeoX)用的是旋转位置编码。
它换了个方向:不动词向量,只转 Q 和 K。
先讲原理:把位置当成转动的指针
想象每个 token 里藏着几个指针。 每个指针都有一个自己的转速。
token 在第 个位置,指针就走了 步。 位置越大,走得越远,指针指的方向就不同。
这就是「位置」的表达方式
转了多大角度 = 在什么位置。
位置 5 的指针转了 5 步,位置 10 的转了 10 步—— 角度本身就是位置。
而且指针是连续转的,第 4096 个位置也不会「没地方放」。
关键在于:两个指针的角度差,正好等于位置差。
Q 在位置 ,转了 ; K 在位置 ,转了 。 两者相差 ——只看得到位置差,看不到绝对位置。
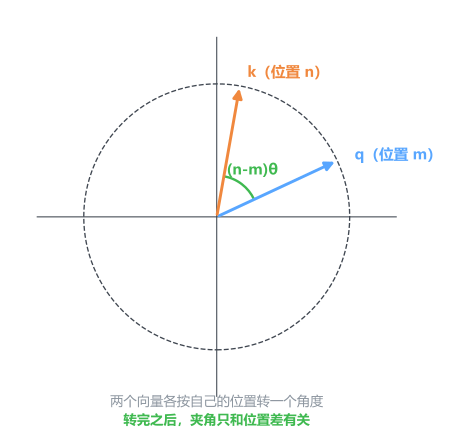
再讲操作:Q 和 K 具体怎么转
实际操作比想象简单:把 Q 的维度两两分组,每组当成一个二维指针来转。
就分成 4 组:、 、、。
每组有自己的转速,从前往后越来越慢:
每个位置 ,第 组就转 度。
举个实在的例子
取 ,。四组的转速和转角:
组 | 维度 | 转速 | 转角 |
|---|---|---|---|
1 | 0, 1 | 1.0 | = 286.5° |
2 | 2, 3 | 0.1 | = 28.6° |
3 | 4, 5 | 0.01 | = 2.9° |
4 | 6, 7 | 0.001 | = 0.3° |
前面转得多,后面转得少
第一组几乎转了整整一圈(286°),最后一组只挪了 0.3°。
这就是「秒针 / 时针」那套: 前面几组负责「精确定位到第几个词」,后面几组只负责「大方向」, 这样位置再长也有足够的表示空间。
拿一个具体的 Q 来转。设 (每组都是单位向量(1,0)):
第1组 [1,0] 转 286.5° -> [ 0.2837, -0.9589] 第2组 [1,0] 转 28.6° -> [ 0.8776, 0.4794] 第3组 [1,0] 转 2.9° -> [ 0.9988, 0.0500] 第4组 [1,0] 转 0.3° -> [ 1.0000, 0.0050] 旋转后的 q = [0.2837, -0.9589, 0.8776, 0.4794, 0.9988, 0.0500, 1.0000, 0.0050]每一组都还是原来的长度 1,只是方向转了。 这就是「旋转不改变语义、只改变方向」的意思。
K 也一模一样地转
设 K 在位置 ,用同样的四组转速转:
第1组 转 2×1.0 = 114.6° 第2组 转 2×0.1 = 11.5° 第3组 转 2×0.01 = 1.1° 第4组 转 2×0.001 = 0.1°Q 转 Q 的,K 转 K 的,各自按自己的位置。 然后照常算点积。
验证:点积只认位置差
用上面这对 Q(位置 5)和 K(位置 2),差是 3:
旋转前 q · k = 0.000000 旋转后 q · k = 0.469636再换一对,绝对位置不同,但差还是 3:
Q 位置 | K 位置 | 位置差 | 点积 |
|---|---|---|---|
5 | 2 | 3 | 0.469636 |
10 | 7 | 3 | 0.469636 |
这就是 RoPE 的全部意义
绝对位置被完全抵消掉了,点积只剩下位置差。
用一句话说:以绝对位置的方式编码,却得到相对位置的感知。
模型不用再自己学「怎么从绝对位置推相对位置」了—— 这一步在旋转里天然完成了。
比正弦好在哪
正弦(相加) | RoPE(旋转) | |
|---|---|---|
动的是什么 | 词向量 | Q 和 K |
对语义的影响 | 位置和词义混在一起 | 只改方向,长度不变 |
相对位置 | 要模型自己学 | 点积里天然带着 |
外推 | 超长会进没见过的频率区 | 连续转,能平滑延伸 |
「语义上不会偏移太多」这条最直观: 相加是往词向量里硬塞东西,会改变它;旋转只是把箭头转个方向, 长度一模一样。
代码
import torch def precompute_freqs_cis(d_model, max_len=32768, base=10000.0): """预先算好每个位置、每一组的角度""" # 每组的转速,从 1 一路降到 1/base freqs = 1.0 / (base ** (torch.arange(0, d_model, 2).float() / d_model)) # 位置 × 转速 = 角度 t = torch.arange(max_len).float() freqs = torch.outer(t, freqs) # (max_len, d_model/2) # 复制一份拼起来,凑成 d_model 维 cos = torch.cat([torch.cos(freqs)] * 2, dim=-1) sin = torch.cat([torch.sin(freqs)] * 2, dim=-1) return cos, sin def apply_rope(x, cos, sin): """把 x 按位置旋转。x: (B, T, d_model)""" def rotate_half(v): h = v.shape[-1] // 2 # 前后两半交换,前半段取负 return torch.cat([-v[..., h:], v[..., :h]], dim=-1) T = x.size(1) cos = cos[:T].unsqueeze(0) sin = sin[:T].unsqueeze(0) # 这就是二维旋转公式的批量写法 return x * cos + rotate_half(x) * sin用起来:
d_model = 64 cos, sin = precompute_freqs_cis(d_model) q = torch.randn(2, 16, d_model) # (batch, 长度, 维度) k = torch.randn(2, 16, d_model) q = apply_rope(q, cos, sin) k = apply_rope(k, cos, sin) # 旋转之后,q @ k.T 自带相对位置 scores = q @ k.transpose(-2, -1)rotate_half 为什么是「交换 + 取负」
一个二维向量 转角度 的结果是:
把它拆成两项正好是 加上 。
而 就是「前后交换、前者取负」。 所以一行代码就能批量转完所有组。
这一课留下的三个数
数 | 值 | 含义 |
|---|---|---|
转速基数 | 10000 | |
位置 5 各组转角 | 286.5° / 28.6° / 2.9° / 0.3° | 前面快,后面慢 |
点积取决于 | 只有位置差,没有绝对位置 |
下一课
顺序问题解决了,回去拆解码器。
它比编码器多一个子层——那个子层正是接收编码器信息的地方。 还要讲那个「不许看后面」的掩码。