编码器的一层
这一课在哪
上一课看清了整体:6 层编码器竖着叠起来。 这一课把其中一层拆开。
六层是同一个结构复制六份,区别只在参数各是各的。 所以只要理解一层,其余五层就都懂了。
一层的完整结构
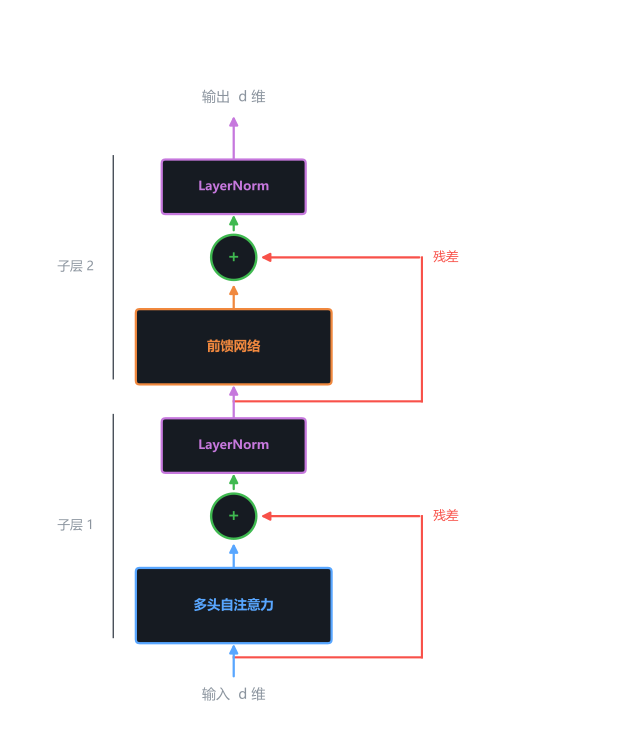
一层里只有两个子层:
子层 | 做什么 | 外面套什么 |
|---|---|---|
子层 1 | 多头自注意力 | 残差 + LayerNorm |
子层 2 | 前馈网络 | 残差 + LayerNorm |
两处,不是一处
每个子层后面都跟着一个「加残差 → LayerNorm」, 所以一层里有两组。
顺序是先加残差,再归一化:
残差本身在第 31 章 ResNet 讲过,这里不重复。 它带来一个硬约束——子层的输出维度必须等于输入维度, 所以整张图里所有箭头一样粗。
LayerNorm 在做什么
两件事,一句话说完:
定义
① 对最后一个维度(或指定的维度)做标准化。 减均值、除标准差,把这个向量拉成均值 0、方差 1。
② 再用 缩放和平移。 和 是可学习的, 让模型自己决定「要不要还原一部分」。
为什么要这么做?
数据经过一层层的矩阵乘和激活,分布会越飘越远—— 有的维度数值上千,有的接近 0。这种分布很难训。
归一化把它拉回一个集中的范围, 于是:
结果 | 为什么 |
|---|---|
梯度更新更稳定 | 不会因为某一维数值过大而把梯度推到爆炸或消失 |
收敛更快 | 每一层拿到的输入尺度一致,学习率不用迁就最坏的那层 |
为什么不用 BatchNorm
BatchNorm 是跨样本算均值和方差,要求同一批里长度整齐。
但这里是变长序列,而且推理时可能一次只来一句—— 跨样本根本算不了。
LayerNorm 只看自己这个向量,和 batch 里别的样本无关, 天然适配。
前馈网络
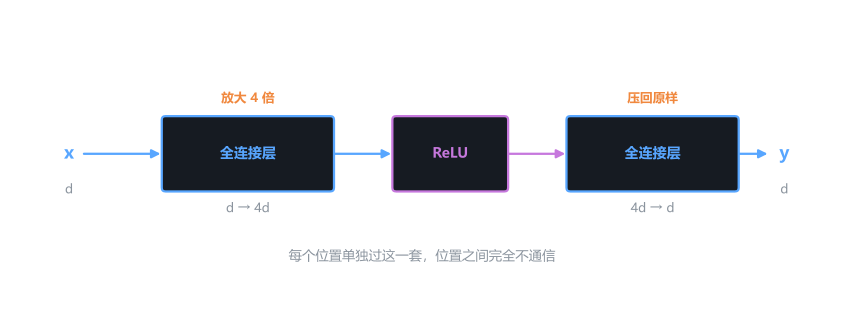
就是两个全连接层:先放大到 4 倍(512 → 2048), 过 ReLU,再缩回原来的大小(2048 → 512)。
撑大那一步是给模型一个更宽的工作区, 在 2048 维里做组合比在 512 维里自由;压回来是为了让残差能相加。
一个容易读错的地方
它的名字叫「基于位置的前馈网络」,因为 序列里所有位置用的都是同一套全连接层。
「同一套」说的是权重,不是位置
很多读者读成「把所有位置混在一起算」,正好读反了。
每个位置单独过这个网络,位置之间完全不通信。
图上那个「每个位置单独过这一套,位置之间完全不通信」就是这个意思。
那它有什么用
注意力的本质是加权平均,而加权平均是线性运算。
一堆线性运算叠起来还是线性运算——堆 100 层等于 1 层。
前馈网络里的 ReLU 是整层唯一的非线性来源。 没有它,多层堆叠就白堆了。
多头自注意力(前面讲过,这里只交代分工)
第 36.2 和 36.6 课已经讲透了多头。这里只说它在这一层里的两个事实:
事实 | 说明 |
|---|---|
每个头都拿全部 token | 八个头拿到的输入完全一样,只是各有各的投影矩阵。 每个头同时看整句的所有位置,不是一人分一段 |
每个头只算 64 维 | 512 维切成 8 份。分成 8 个头并不增加参数—— 8 个 |
八个头各自算出一个 64 维的结果,拼接起来回到 512 维, 最后再过一个矩阵 压回原大小。
这个 不能省:不加它,八个头永远是八段互不相干的信息, 后面没法当整体用。
一层干完,交给下一层
到这里一层就完整了。它的输出原样作为下一层的输入—— 维度不变,形状不变,还是 。
重复 6 次,最后得到 ,交给解码器。
整层串起来
class EncoderLayer(nn.Module): def __init__(self, d_model=512, n_heads=8, d_ff=2048): super().__init__() self.self_attn = MultiHeadAttention(d_model, n_heads) self.ffn = PositionWiseFFN(d_model, d_ff) self.norm1 = nn.LayerNorm(d_model) self.norm2 = nn.LayerNorm(d_model) def forward(self, x, mask=None): # 子层 1:多头自注意力(Q K V 都是自己) x = self.norm1(x + self.self_attn(x, x, x, mask)) # 子层 2:前馈网络 x = self.norm2(x + self.ffn(x)) return x对照上面那张图看这两行:
代码 | 图上哪一段 |
|---|---|
| 子层 1 的方框,三个 x 就是 Q K V 同源 |
| 红色那条残差旁路 |
| 紫色那个 LayerNorm |
| 子层 2 的方框 |
代码和图的对应关系要看清
一行代码 = 一个子层,写法是完全一样的套路: norm(x + 子层(x))
两个子层唯一的区别是中间那个函数换了 (self_attn 换成 ffn)。
所以整个 Transformer 的代码看起来会非常重复——那是正常的。
这里用到的 MultiHeadAttention 和 PositionWiseFFN 两个零件,后面单独给实现。
这一层有多少参数
部分 | 参数 | 占比 |
|---|---|---|
多头注意力(四个 512×512 矩阵) | 1,050,624 | 33% |
前馈网络(512→2048→512) | 2,099,712 | 67% |
两个 LayerNorm | 2,048 | 0.06% |
一层合计 | 3,152,384 |
参数最多的是前馈网络,不是注意力。六层就是 3,152,384 × 6 ≈ 18.9M。
下一课
编码器拆完了。下一课拆解码器—— 它比编码器多一个子层,多出来的那个正是接收编码器信息的地方。
还要讲那个「不许看后面」的掩码。